
3 传输层
1 概述和传输层服务
1.1 传输服务和协议
- 为运行在不同主机上的应用进程提供逻辑通信
- 传输协议运行在端系统
- 发送方:将应用层的报文分成报文段,然后传递给网络层
- 接收方:将报文段重组成报文,然后传递给应用层
- 有多个传输层协议可供应用选择
- Internet: TCP 和 UDP
1.2 传输层 vs 网络层
- 网络层服务:主机之间的逻辑通信
- 传输层服务:进程之间的逻辑通信
- 依赖于网络层的服务
- 延时、带宽
- 并对网络层的服务进行增强
- 数据丢失、顺序混乱、加密
- 依赖于网络层的服务
类比:Ann家的12个小孩给另Bill家的12个小孩发信
- 主机 = 家庭
- 进程 = 小孩
- 应用层报文 = 信封中的信件
- 传输层协议 = Ann 和 Bill
- 为家庭小孩提供复用解复用服务(一个人带多封信,一个人收多封信)
- 网络层协议 = 邮政服务
- 家庭-家庭的邮包传输服务
1.3 Internet 传输层协议
- 可靠、保序的传输:TCP
- 多路复用、解复用
- 拥塞控制
- 流量控制
- 建立连接
- 不可靠、不保序的传输:UDP
- 多路复用、解复用
- 没有为尽力而为的 IP 服务添加更多的其它额外服务
- 都不提供的服务:
- 延时保证
- 带宽保证
操作系统负责维护套接字与端口之间的映射关系
- 端口存在于数据包中,而套接字存在于操作系统内核中
| 协议类型 | 套接字类型 | 操作系统存储的映射元组 |
|---|---|---|
| UDP | SOCK_DGRAM | (本地端口, 本地IP) ⟷ 套接字 |
| TCP | SOCK_STREAM | (本地端口, 本地IP, 远程端口, 远程IP) ⟷ 套接字 |
2 多路复用/解复用
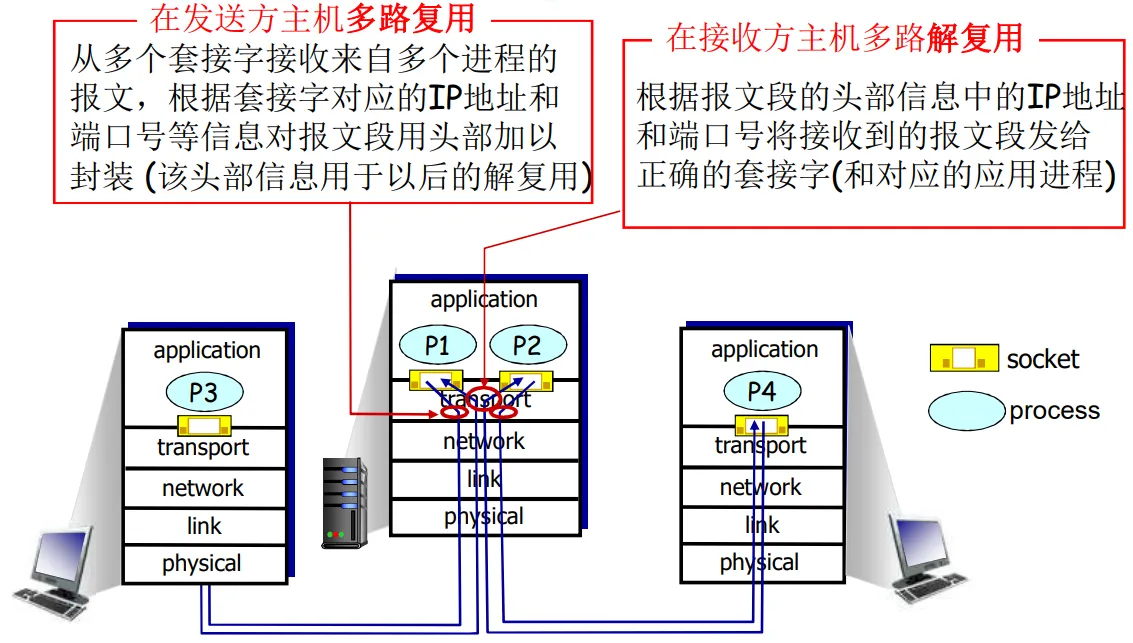
通俗例子:
- 主机(Host/IP地址): 就像一栋公寓楼。
- 应用进程(Process P1/P2/P3/P4): 就像公寓里的各个住户。
- 套接字(Socket): 就像每个住户专属的信箱。
- 传输层(Transport Layer): 就像公寓楼底层的收发室大爷。
网络层(即IP层)只负责把数据包送到“哪栋公寓楼”(主机到主机),而传输层则负责把数据准确地送到“哪个住户的信箱”里(进程到进程)。这个过程就是复用和解复用。
发送方的“多路复用” (Multiplexing):
- 场景: 假设中间的服务器上同时运行着两个应用进程(比如 P1 是 Web 服务,P2 是邮件服务)。这两个进程都需要向外发送数据。
- 动作: P1 和 P2 分别把数据塞进自己的 Socket。传输层(收发室大爷)将这些来自不同 Socket 的数据块收集起来。
- 核心封装: 传输层在每个数据块前面加上一个 “头部(Header)”,生成传输层报文段。这个头部里最关键的信息就是源端口号和目的端口号(写上寄件人和收件人的房间号)。
- 结果: 多个进程的数据被统一打包,顺着网络层的一条网线发了出去。这就是“多路复用”(把多条路的数据汇聚到一条路上发送)。
接收方的“多路解复用” (Demultiplexing):
- 场景: 接收方主机(比如右侧的 PC 或者中间的服务器)从网络层接收到了一个数据报文。
- 动作: 数据到达传输层后,传输层(收发室大爷)会拆开网络层的包装,查看传输层头部(Header)里的信息。
- 核心分发: 它提取出头部中的目的 IP 地址和目的端口号。根据这个端口号,它就能精确地找到对应的 Socket(Socket 中又包含 pid)。
- 结果: 传输层将数据准确无误地投入到对应的 Socket 中,最终被对应的应用程序(如 P4)读取。这就是“多路解复用”(把一条路上来的数据,分发给多条路上的不同进程)。
3 无连接传输 UDP
UDP: User Datagram Protocol(用户数据报协议)
- “尽力而为”的服务,报文段可能
- 丢失、乱序
- 无连接:
- UDP发送端和接收端之间没有握手
- 每个UDP报文段都被独立地处理
- UDP 被用于:
- 流媒体(丢失不敏感,速率敏感、应用可控制传输速率)
- DNS
- 在UDP上可行可靠传输:
- 在应用层增加可靠性
- 应用特定的差错恢复
为什么要有 UDP?
- 不建立连接(会增加延时)
- 简单:在发送端和接收端没有连接状态
- 报文段的头部很小(开销小)
- 无拥塞控制和流量控制:
- UDP可以尽可能快的发送报文段
- 应用->传输的速率= 主机->网络的速率
UDP报文段格式:
<-----------------32 bits------------------>
+--------------------+---------------------+
|      源端口号       |     目的端口号       |
+--------------------+---------------------+
|        长度         |        校验和       |
+--------------------+---------------------+
|            应用程序数据(报文)            |
+------------------------------------------+

长度:UDP报文段的字节数,包括头部
UDP 校验和
目标:检测在被传输报文段中的差错(如比特反转)
发送方:
- 将报文段的内容视为 16 比特的整数
- 校验和:所有报文段的加法和(1的补运算)
- 发送方将校验和放在 UDP 的校验和字段
接收方:
- 计算接收到的报文段的校验和
- 检查计算出的校验和与校验和字段的内容是否相等:
- 不相等 —— 检测到差错
- 相等 —— 没有检测到差错,但也许还是有差错
- 残存错误
Internet 校验和的例子
- 注意:求和时,在最高位的进位要回卷,再加到结果上
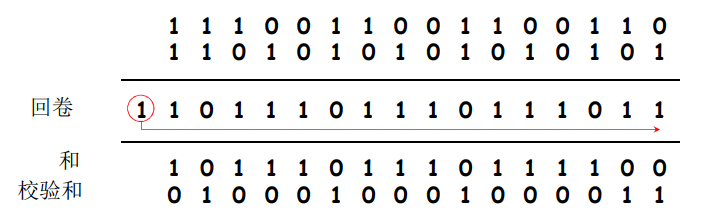
- 校验和是对和的取反
- 目标端:校验范围 + 校验和 = 1111111111111111 则通过校验
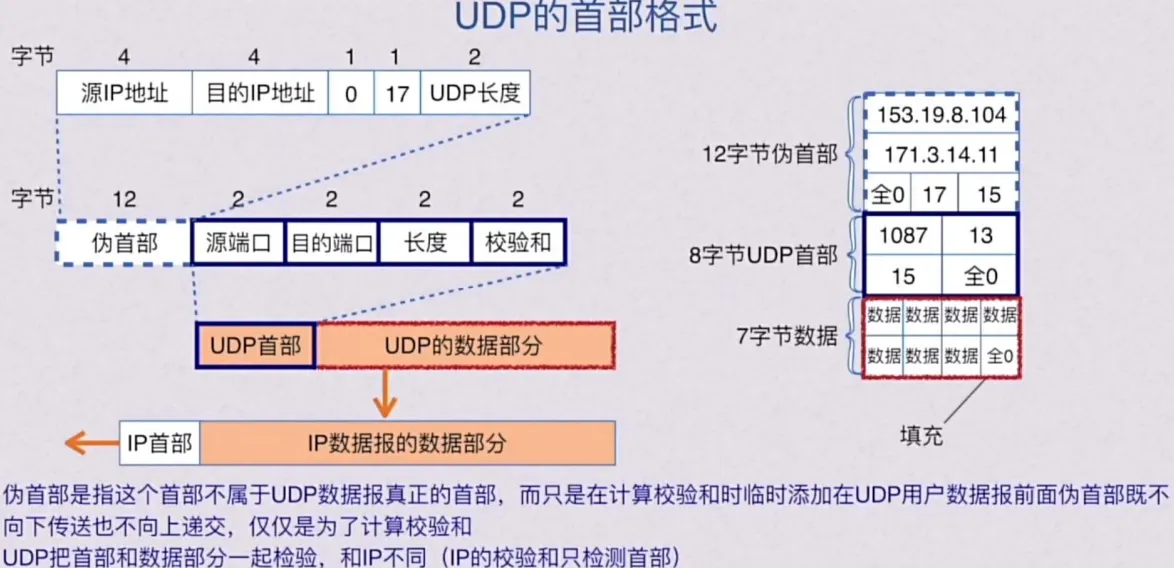
- 对分组内容进行可选的差错校验
- (校验和字段 = 0 表示“不验证校验和”)
- 源端口号也是可选的
- 在某些情况下可用于回复发送方
4 可靠数据传输的原理
可靠数据传输(rdt) 在应用层、传输层和数据链路层都很重要
rdt1.0:在可靠信道上的可靠数据传输
- 下层的信道是完全可靠的
- 没有比特出错
- 没有分组丢失
- 发送方将数据发送到下层信道(封装)
- 接收方从下层信道接收数据(解封装)
rdt2.0:具有比特差错的信道
- 下层信道可能会出错:将分组中的比特翻转
- 用校验和来检测比特差错
- 问题:怎样从差错中恢复:
- 确认(ACK):接收方显式地告诉发送方分组已被正确接收
- 否定确认(NAK): 接收方显式地告诉发送方分组发生了差错
- 发送方收到 NAK 后,发送方重传分组
- rdt2.0 中的新机制:采用差错控制编码进行差错检测
- 发送方差错控制编码、缓存
- 接收方使用编码检错
- 接收方的反馈:控制报文(ACK,NAK):接收方 -> 发送方
- 发送方收到反馈做相应的动作
rdt2.0 的致命缺陷:如果 ACK/NAK 出错
- 重传?可能出错
- 不重传?可能死锁(或出错)
- 需要引入新的机制:序号
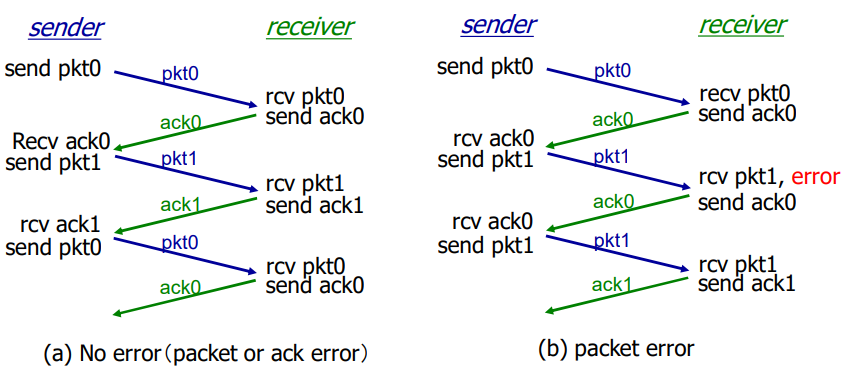
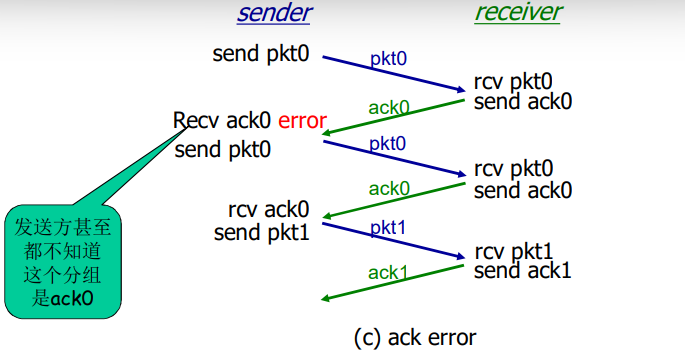
rdt2.1:处理出错的ACK/NAK
处理重复:
- 发送方在每个分组中加入序号
- 如果 ACK/NAK 出错,发送方重传当前分组
- 接收方由序号丢弃(不发给上层)重复分组
这里使用的是停等协议:发送方发送一个分组,然后等待接收方的应答
发送方:
- 在分组中加入序列号
- 两个序列号(0,1)就足够了
- 一次只发送一个未经确认的分组
- 必须检测 ACK/NAK 是否出错(需要差错检测码 EDC)
- 状态数变成了两倍
- 必须记住当前分组的序列号为 0 还是 1
接收方:
- 必须检测接收到的分组是否是重复的
- 状态会指示希望接收到的分组的序号为 0 还是 1
- 注意:接收方并不知道发送方是否正确收到了其 ACK/NAK
- 没有安排确认的确认
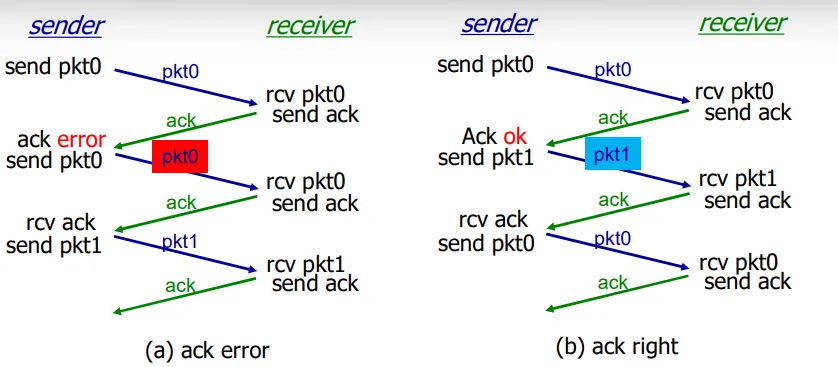
接收方不知道它最后发送的 ACK/NAK 是否被正确地收到
- 发送方不对收到的 ack/nak 给确认,没有所谓的确认的确认
- 接收方发送 ack,如果后面接收方收到的是:
- 老分组 p0?则 ack 错误
- 下一个分组?P1,ack 正确
rdt2.2:无 NAK 的协议
- 功能同 rdt2.1,但只使用ACK(ack 要编号)
- 接收方对最后正确接收的分组发 ACK,以替代 NAK
- 接收方必须显式地包含被正确接收分组的序号
- 当收到重复的ACK时,发送方与收到 NAK 采取相同的动作:重传当前分组
- 为后面的一次发送多个数据单位做一个准备
- 一次能够发送多个
- 每一个的应答都有:ACK、NAK,麻烦
- 使用对前一个数据单位的ACK,代替本数据单位的 NAK
- 确认信息减少一半,协议处理简单
rdt3.0:具有比特差错和分组丢失的信道
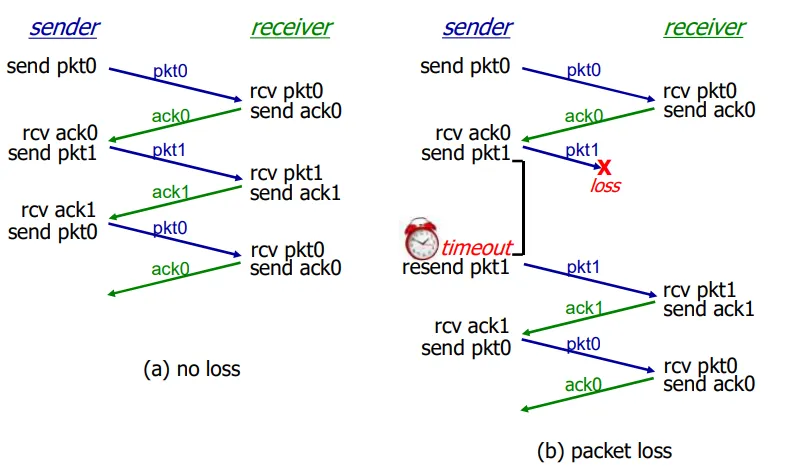
新的假设:下层信道可能会丢失分组(数据或ACK)
- 会死锁
- 机制还不够处理这种状况:
- 检验和
- 序列号
- ACK
- 重传
方法:发送方等待 ACK 一段合理的时间,超时重传
- 发送方超时重传:如果到时没有收到 ACK->重传
- 问题:如果分组(或ACK)只是被延迟了:
- 重传将会导致数据重复,但利用序列号已经可以处理这个问题
- 接收方必须指明被正确接收的序列号
- 需要一个倒计数定时器
链路层的 timeout 时间确定的,传输层 timeout 时间是适应式的
发送方:
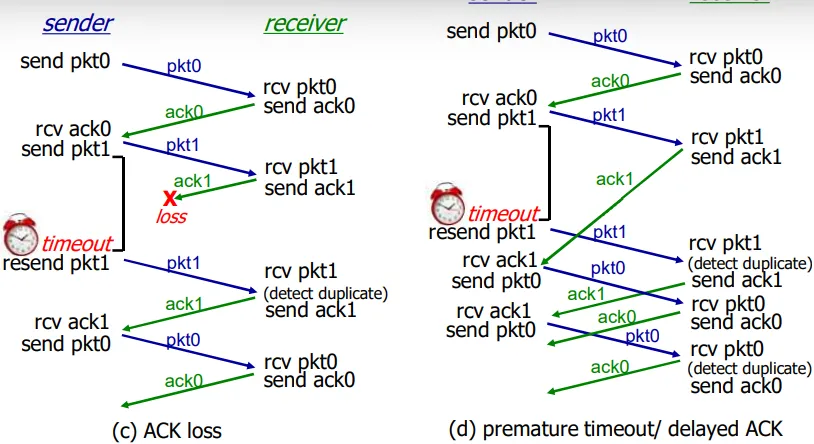
- 过早超时(延迟的ACK)也能够正常工作
- 但是效率较低,一半的分组和确认是重复的
- 设置一个合理的超时时间也是比较重要的
rdt3.0 的性能
- rdt3.0可以工作,但链路容量比较大的情况下,性能很差
- 链路容量比较大,一次发一个 PDU 的不能够充分利用链路的传输能力
例:1 Gbps的链路,15 ms 端-端传播延时,分组大小为1kB:
- \(U_{\text{sender}}\):利用率 – 忙于发送的时间比例
- 每 30ms 发送 1KB 的分组 -> 270kbps=33.75kB/s 的吞吐量(在1Gbps 链路上)
- 瓶颈在于:网络协议限制了物理资源的利用
停 - 等操作:
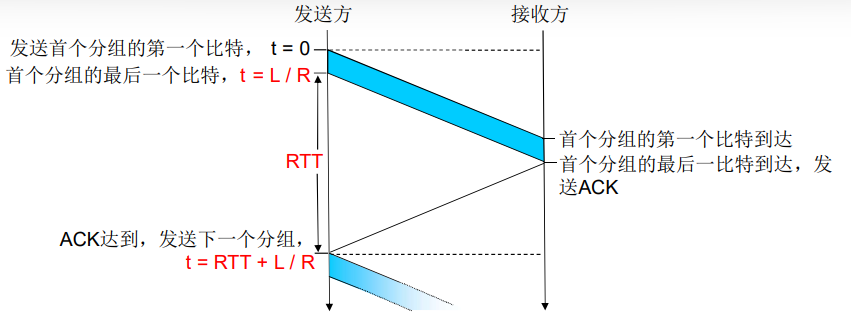
流水线:提高链路利用率
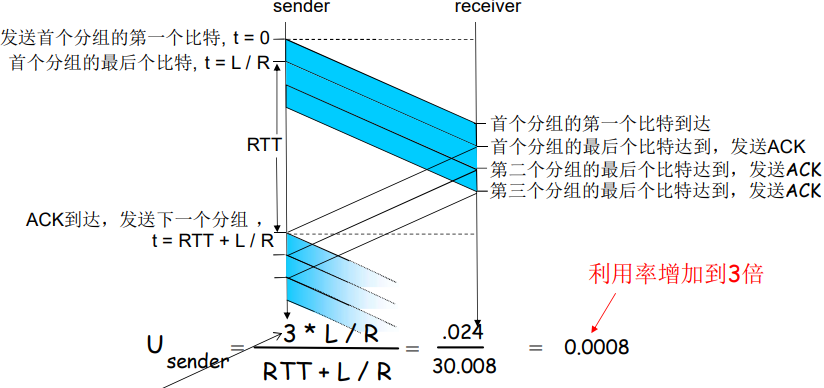
- 增加 n,能提高链路利用率
- 但当达到某个 n,其 u=100% 时,无法再通过增加n,提高利用率
- 瓶颈转移了 -> 链路带宽
流水线协议
流水线:允许发送方在未得到对方确认的情况下一次发送多个分组
- 必须增加序号的范围: 用多个bit表示分组的序号
- 在发送方/接收方要有缓冲区
- 发送方缓冲:
- 未得到确认,可能需要重传
- 接收方缓存:
- 上层用户取用数据的速率 ≠ 接收到的数据速率
- 接收到的数据可能乱序,排序交付(可靠)
- 发送方缓冲:
两种通用的流水线协议:回退N步(GBN) 和 选择重传(SR)
先补充介绍滑动窗口协议作为铺垫
通用:滑动窗口协议
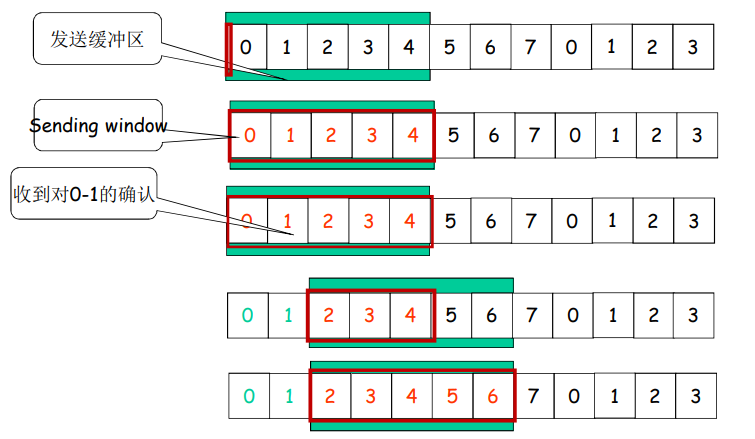
滑动窗口协议:发送方和接收方都维护一个窗口
- 发送缓冲区
- 形式:内存中的一个区域,落入缓冲区的分组可以发送
- 功能:用于存放已发送,但是没有得到确认的分组
- 必要性:需要重发时可用
- 发送缓冲区的大小:一次最多可以发送多少个未经确认的分组
- 停止等待协议 = 1
- 流水线协议 > 1,合理的值,不能很大,链路利用率不能够超 100%
- 发送缓冲区中的分组
- 未发送的:落入发送缓冲区的分组,可以连续发送出去
- 已经发送出去的、等待对方确认的分组:发送缓冲区的分组只有得到确认才能删除
发送窗口:发送缓冲区的一个子集
- 已发送但是未经确认分组的序号构成的空间
- 一开始没有发生任何一个分组
- 后沿 = 前沿
- 发送窗口尺寸为 0
- 每发送一个分组,前沿前移一个单位
- 发送窗口前沿移动的极限:不能够超过发送缓冲区
- 发送窗口后沿移动
- 条件:收到老分组的确认
- 结果:发送缓冲区罩住新的分组,来了分组可以发送
- 移动的极限:不能够超过前沿
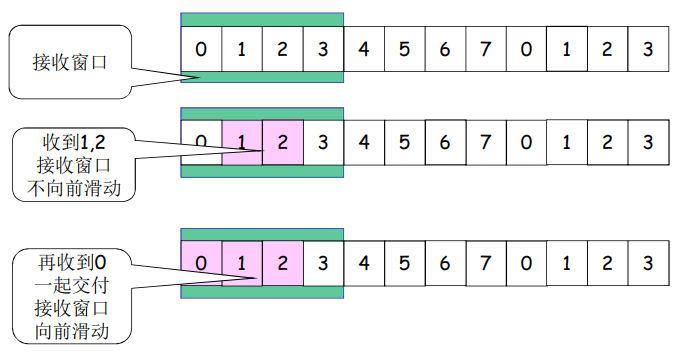
接收窗口 = 接收缓冲区
- 接收窗口用于控制哪些分组可以接收
- 只有收到的分组序号落入接收窗口内才允许接收
- 若序号在接收窗口之外,则丢弃
- 接收窗口尺寸 Wr=1,则只能顺序接收
- 接收窗口尺寸 Wr>1 ,则可以乱序接收
- 但提交给上层的分组,要按序
接收窗口的滑动和发送确认
- 滑动:
- 低序号的分组到来,接收窗口移动
- 高序号分组乱序到,缓存但不交付(rdt 不允许失序),不滑动
- 发送确认:
- 接收窗口尺寸 = 1:发送连续收到的最大的分组确认(累计确认,顺序接收)
- 接收窗口尺寸 > 1:收到分组,发送那个分组的确认(非累计确认)
- 收到分组3,发送ACK3,但不代表分组2已被收到
滑动窗口的吞吐量
- 如果窗口大小为 n,则吞吐量大约为
- MIN(n*DATA/RTT, 链路带宽)
- 与停等协议对比:Data/RTT
- 当 n 过大时会发生什么?
- 网络拥塞与丢包:发送方往网络里注入了远超路由器/交换机缓存承受能力的数据包,导致路由器排队溢出,从而引起严重的丢包
- 延迟激增:大量数据包在路由器的队列里排队,导致 RTT 异常增大,网络出现明显卡顿
- 触发大量重传:一旦发生丢包,滑动窗口协议需要重传丢失的数据,反而会导致有效吞吐量大幅下降
- 接收方内存溢出
GBN 协议和 SR 协议的异同
相同之处:
- 发送窗口 > 1
- 一次能够可发送多个未经确认的分组
不同之处:
- GBN: 接收窗口尺寸 = 1
- 接收端:只能顺序接收
- 发送端:从表现来看,一旦一个分组没有发成功,如:
0,1,2,3,4;假如1未成功,2,3,4都发送出去了,要返回1再发送GB1(超时重发的是整个发送窗口)
- SR : 接收窗口尺寸 > 1
- 接收端:可以乱序接收
- 发送端:发送
0,1,2,3,4,一旦1未成功,2,3,4已发送,无需重发,选择性发送1(独立确认,每个分组单独一个计时器,超时重发的只是这个分组)
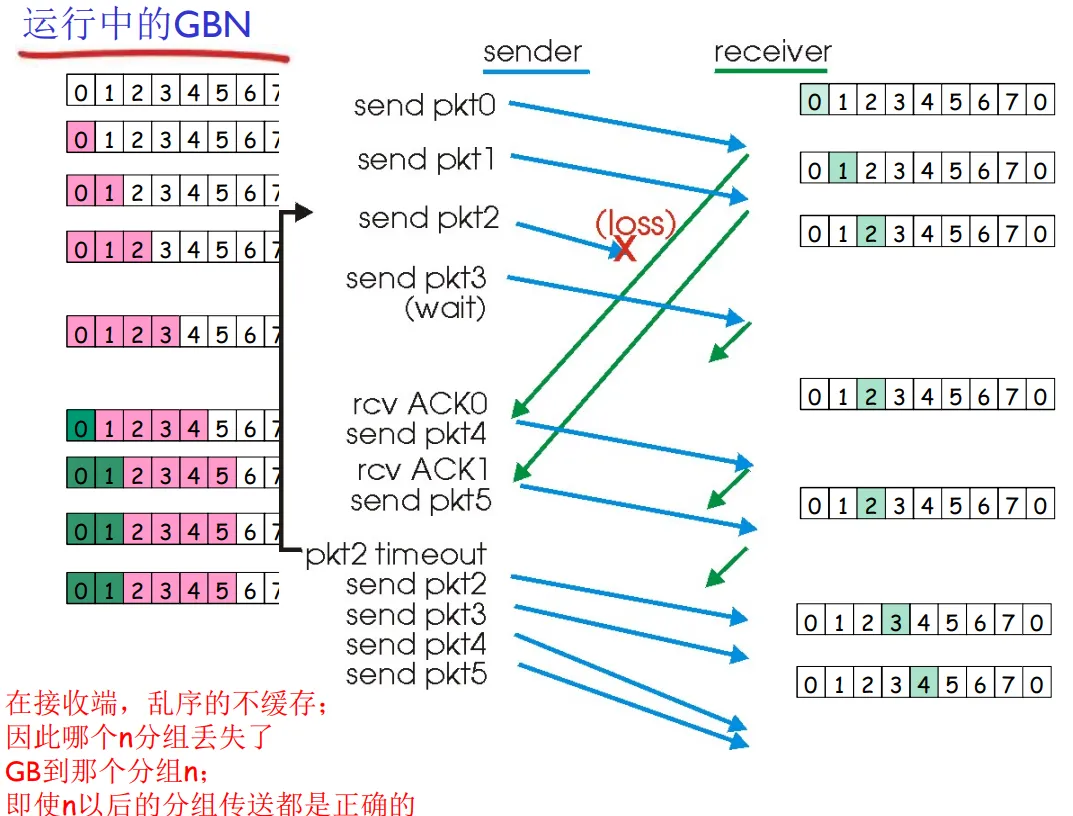
Go-back-N
- 发送端最多在流水线中有 N 个未确认的分组
- 接收端只是发送累计确认
- 接收端如果发现 gap,不确认新到来的分组
- 发送端拥有对最老的未确认分组的定时器
- 只需设置一个定时器
- 当定时器到时时,重传所有未确认分组
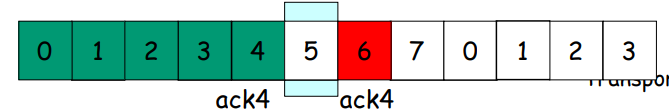
接收方:
- 只发送 ACK:对顺序接收的最高序号的分组
- 可能会产生重复的 ACK
- 接收窗口 = 1,只一个变量就可表示接收窗口
- 对乱序的分组:
- 丢弃(不缓存)
- 对顺序接收的最高序号的分组进行确认-累计确认
Selective Repeat
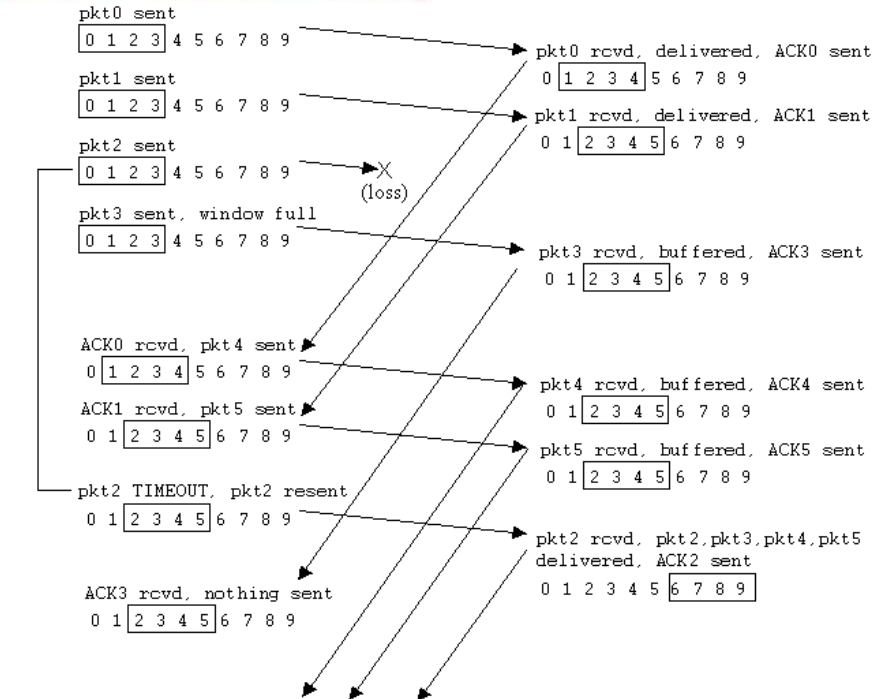
- 接收方对每个正确接收的分组,分别发送 ACKn(非累积确认)
- 接收窗口 > 1
- 可以缓存乱序的分组
- 最终将分组按顺序交付给上层
- 接收窗口 > 1
- 发送方只对那些没有收到 ACK 的分组进行重发 —— 选择性重发
- 发送方为每个未确认的分组设定一个定时器
- 发送窗口的最大值(发送缓冲区)限制发送未确认分组的个数
| GBN | SR | |
|---|---|---|
| 优 点 | 简单,所需资源少(接收方一个缓存单元) | 出错时,重传一个代价小 |
| 缺 点 | 一旦出错,回退 N 步代价大 | 复杂,所需要资源多(接收方多个缓存单元) |
| 适用范围 | 出错率低 | 链路容量大(延迟大、带宽大) |
- 链路利用率与窗口大小 滑动窗口机制能够实现链路的完全利用,但这有一个前提条件:窗口的大小必须足够大,以覆盖传输延迟带来的 “在途” 数据量
- 发送方的缓冲需求 发送方必须缓存所有已发送但尚未被确认的分组。这是为了应对可能发生的丢包情况,确保在需要时能够对这些分组进行重传。
- 接收方的处理能力 接收方具备一定的能力来接收和处理乱序到达的分组,但这种能力受限于接收方自身的缓冲区大小。
- 实现复杂度 协议的具体实现难度取决于所采用的策略细节,主要体现为回退 N 步与选择重传之间的区别
窗口的最大尺寸*
假设序列号用 \(n\) 位比特表示,那么序列号的总数是 \(k = 2^n\)
- GBN:\(2^n - 1\)
- SR:\(2^{n-1}\)(即序列号空间的一半)
例:\(n=2\),序列号为 0, 1, 2, 3,若 SP 窗口为 3(超过限制2)
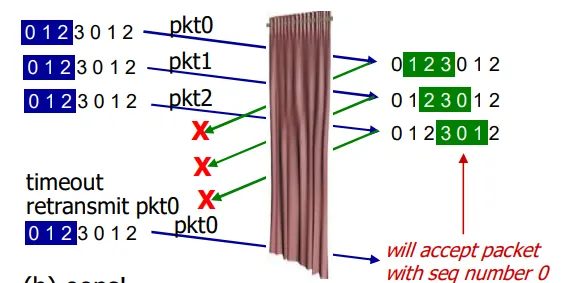
- 接收方收到重传的旧 pkt0 后,误以为这是全新的数据并接受它
为了避免上述重叠问题,必须满足:
对于 SR 协议,由于发送窗口和接收窗口大小通常相等(设为 \(W\)),公式变为:
对于 GBN 协议,由于接收窗口大小始终为 1,公式变为:
5 面向连接的传输:TCP
- 点对点:
- 一个发送方,一个接收方
- 可靠的、按顺序的字节流:
- 没有报文边界
- 管道化(流水线):
- TCP 拥塞控制和流量控制设置窗口大小
- 发送和接收缓存
- 全双工数据:
- 在同一连接中数据流双向流动
- MSS:最大报文段大小(把应用进程传下来的字节流切片)
- 面向连接:
- 在数据交换之前,通过握手(交换控制报文)初始化发送方、接收方的状态变量
- 有流量控制:
- 发送方不会淹没接收方
5.1 段结构
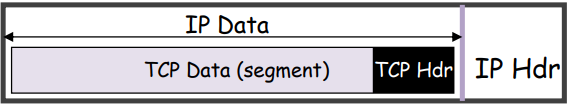
- IP 分组
- 不超过最大传输单元(MTU)
- 例如,以太网中最多 1500 字节
- TCP 分组
- 包含 TCP 头部和数据的 IP 分组
- TCP 头部 ≥ 20 字节
- TCP 报文段
- 不超过最大报文段大小(MSS)字节
- 例如,从字节流中取最多 1460 个连续字节
- MSS = MTU –(IP 头部)–(TCP 头部)
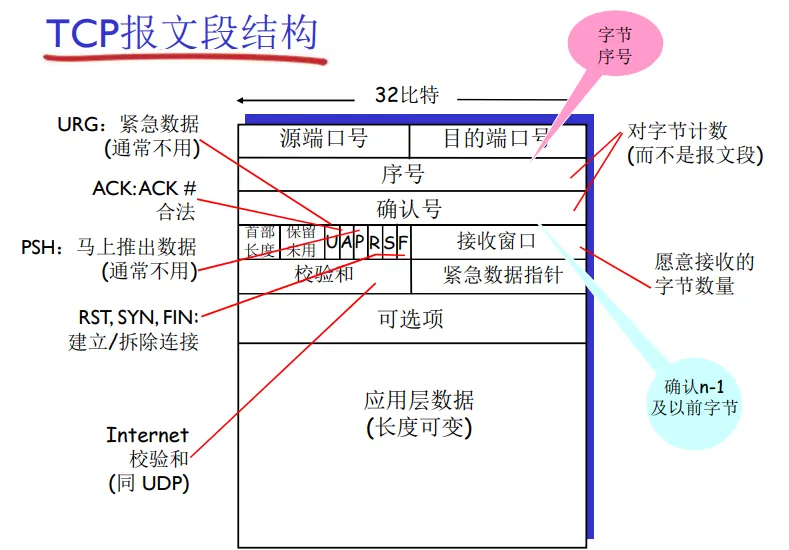
首部长度:Number of 4-byte words in the header
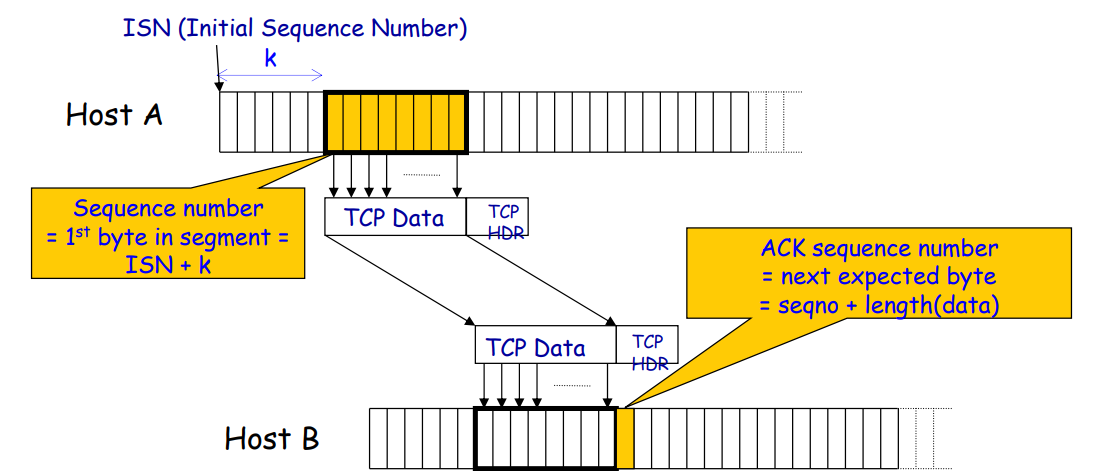
序号,确认号
- 序号:对字节计数
- 报文段首字节的在字节流的编号
- (body 起始字节在整个字节流中的偏移量)
- 确认号:
- 期望从另一方收到的下一个字节的序号
- 确认号 - 1 (包括)以前的字节都已经收到
- 累积确认
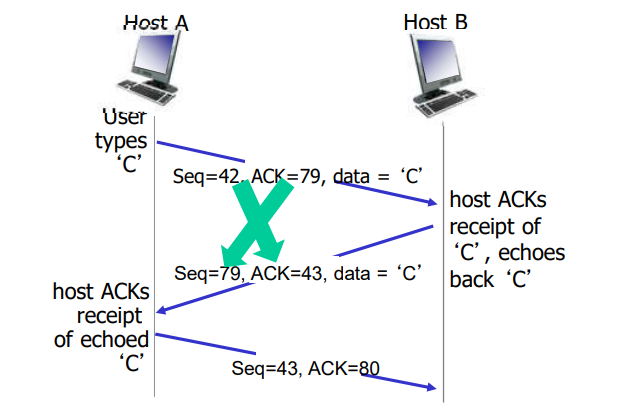
下一个要发送的数据包的序列号(Seqno),等于上一次接收到的 ACK 字段(确认号) 的值
1. 发送方的行为
- 发送数据包:发送方发送一个数据包,其中包含 \(B\) 字节的数据。
- 序列号分配:该数据包的数据起始序列号为 \(X\),因此数据覆盖的序列号范围为 \([X, X+1, \dots, X+B-1]\)。
2. 接收方的确认机制
当接收方收到数据包后,会根据接收情况发送确认号:
-
情况一:数据按序到达
- 如果接收方已经成功接收了序列号 \(X\) 之前的所有数据,那么当前的数据包是连续的。
- ACK 行为:接收方发送 ACK 确认号为 \(X+B\)。
- 含义:表示 \(X+B-1\) 及之前的字节都已收到,期望接收的下一个字节是 \(X+B\)。
-
情况二:存在数据缺失
- 如果接收方已接收的最高连续字节序列号为 \(Y\),且 \(Y+1 < X\)(说明序列号 \(Y+1\) 到 \(X-1\) 之间的数据尚未收到,当前包是乱序或重复的)。
- ACK 行为:接收方发送 ACK 确认号为 \(Y+1\)。
- 注意:即使这个 ACK (\(Y+1\)) 之前已经发送过,接收方仍会再次发送,以此告知发送方它仍在等待 \(Y+1\) 这个字节。
- 发送方发送每个 100B 的分组,序列号为:
- 100, 200, 300, 400, 500, 600, 700, 800, 900, …
- 假设第五个分组(序列号 500)丢失,其他正常
- 确认号序列将为:
- 200, 300, 400, 500(确认 seqno:600), 500(确认 seqno:700), 500(确认 seqno:800), 500(确认 seqno:900), …
TCP 往返延时(RTT)和超时
- 比 RTT 要长:但 RTT 是变化的(远距离的很多跳)
- 长时间的 RTT 分布比较分散
- 短时间的 RTT 分布比较集中
- 太短:太早超时不必要的重传
- 太长:对报文段丢失反应太慢,消极
怎样估计 RTT?
- SampleRTT:测量从报文段发出到收到确认的时间
- 如果有重传,忽略此次测量
- SampleRTT 会变化,因此估计的 RTT 应该比较平滑
- 对几个最近的测量值求平均,而不是仅用当前的 SampleRTT
- 指数加权移动平均
- 过去样本的影响呈指数衰减
- 推荐值:\(\alpha\) = 0.125
但光有平均值不够,网络波动大的时候,需要多留一点安全边界,即
计算 SampleRTT 会偏离 EstimatedRTT 多远:
- 推荐值: \(\beta = 0.25\)
故超时时间间隔设置为:
Karn/Partridge algorithm
1. 样本选择与 RTT 估算
- 忽略重传样本:在计算往返时间时,不使用来自重传分组的 SampleRTT。一旦某个分组被重传,后续该分组的确认将不再用于 RTT 测量(以避免歧义)。
- 计算 EstimatedRTT:使用指数加权移动平均算法,权重系数 \(\alpha = 0.125\)。
2. 超时时间(RTO)的设定
- 基础设定:超时值通常设定为估算 RTT 的两倍,即:\[RTO = 2 \times EstimatedRTT\]
3. 动态调整机制
- 指数退避:每当 RTO 定时器超时(发生超时事件),RTO 的值会翻倍(\(RTO \leftarrow 2 \times RTO\)),直到达到最大值(\(\ge 60\) 秒)。
- 测量值恢复:每当有新的测量值进入(即原始传输成功确认),RTO 会立即回缩并重置为 \(2 \times EstimatedRTT\)。
4. 局限性
- 该机制被指出对 RTT 的变化不够敏感。
Jacobson/Karels algorithm
Problem: need to better capture variability in RTT
- Directly measure deviation
- DevRTT: exponential average of Deviation
5.2 可靠数据传输
- TCP 在 IP 不可靠服务的基础上建立了 rdt
- 管道化的报文段
- GBN or SR
- 累积确认(像GBN)
- 单个重传定时器(像GBN)
- 是否可以接受乱序的,没有规范
- 管道化的报文段
- 通过以下事件触发重传
- 超时(只重发那个最早的未确认段:SR)
- 重复的确认
- 例子:收到了 ACK50,之后又收到 3 个 ACK50
- 此时还没有超时,“快速重传”
TCP 发送方事件
从应用层接收数据
- 用 nextseq 创建报文段
- 序号 nextseq 为报文段首字节的字节流编号
- 如果还没有运行,启动定时器
- 定时器与最早未确认的报文段关联
- 过期间隔:TimeOutInterval
超时
- 重传后沿最老的报文段
- 区别于GBN,GBN全部重传
- 重新启动定时器
- 区别于SR,定时器只有一个
- 既不是GBN也不是SR,而是混合体
收到确认
- 如果是对尚未确认的报文段确认
- 更新已被确认的报文序号
- 如果当前还有未被确认的报文段,重新启动定时器
NextSeqNum = InitialSeqNum
SendBase = InitialSeqNum
/* SendBase-1: 最后一个累积确认的字节 */

loop (forever) {
    switch(event)

    event: data received from application above
        create TCP segment with sequence number NextSeqNum
        if (timer currently not running)
            start timer
        pass segment to IP
        NextSeqNum = NextSeqNum + length(data)

    event: timer timeout
        retransmit not-yet-acknowledged segment with smallest sequence number
        start timer

    event: ACK received, with ACK field value of y
        if (y > SendBase) {
            SendBase = y
            if (there are currently not-yet-acknowledged segments)
                start timer
        }
} /* end of loop forever */
重传
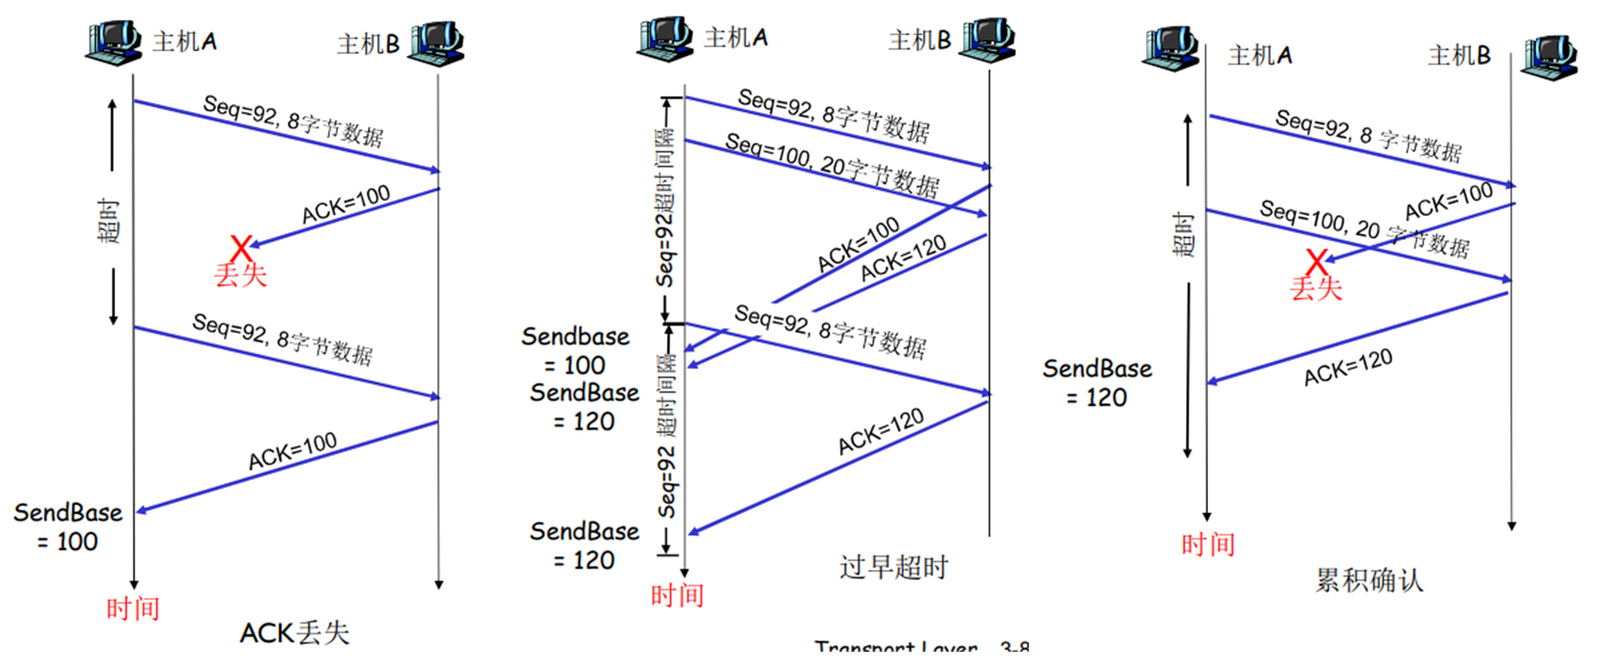
接收方产生TCP ACK的建议
| 接收方的事件 | TCP接收方动作 |
|---|---|
| 所期望序号的报文段按序到达。所有在期望序号之前的都已被确认 | 延迟的ACK(顺顺利利,不干扰发送方)。对另一个按序报文段的到达最多等待500ms。如果下一个报文段在这个时间间隔内没有到达,则发送一个ACK。 |
| 有期望序号的报文段到达。另一个按序报文段等待发送ACK(接着上面的那种情况,当前ACK还未发,但预期的下一个包到达了) | 立即发送单个累积ACK,以确认两个按序报文段。 |
| 比期望序号大的报文段乱序到达。检测出数据流中的间隔 | 立即发送重复的ACK,指明下一个期待字节的序号 |
| 能部分或完全填充接收数据间隔的报文段到达。 | 若该报文段起始于间隔(gap)的低端,则立即发送ACK。 |
快速重传
- 超时周期往往太长:
- 在重传丢失报文段之前的延时太长
- 通过 k 个重复的 ACK 来检测报文段丢失(TCP 使用 k = 3)
- 发送方通常连续发送大量报文段
- 如果报文段丢失,通常会引起多个重复的 ACK
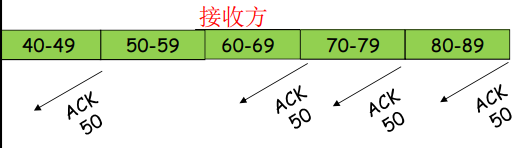
- 如果发送方收到同一数据的 3 个冗余ACK,重传最小序号的段
- 快速重传:在定时器过时之前重发报文段
- 它假设跟在被确认的数据后面的数据丢失了
- 第一个 ACK 是正常的
- 收到第二个该段的 ACK,表示接收方收到一个该段后的乱序段
- 收到第 3,4 个该段的 ACK,表示接收方收到该段之后的 2 个,3 个乱序段,可能性非常大
event: ACK received, with ACK field value of `y`
  if (y > SendBase) {
      SendBase = y
      if (there are currently not-yet-acknowledged segments) {
          start timer
      }
  } else {
      increment count of dup ACKs received for y
      if (count of dup ACKs received for y = 3) {
          resend segment with sequence number y
      }
  }
重传后的两种选择:
- 发送丢失分组,并将滑动窗口向前移动重复 ACK 的数量
- 加快传输速度,但可能出错
- 发送丢失分组,等待 ACK 来移动滑动窗口
- 会因单个丢包而变慢
TCP 应该选择哪一种?—— TCP 的几种变体
5.3 连接管理
在正式交换数据之前,发送方和接收方握手建立通信关系:
- 同意建立连接(每一方都知道对方愿意建立连接)
- 同意连接参数
2 次握手
在网络中,2次握手建立连接总是可行吗?
- 变化的延迟(连接请求的段没有丢,但可能超时)
- 由于丢失造成的重传 (e.g. req_conn(x))
- 报文乱序
- 相互看不到对方
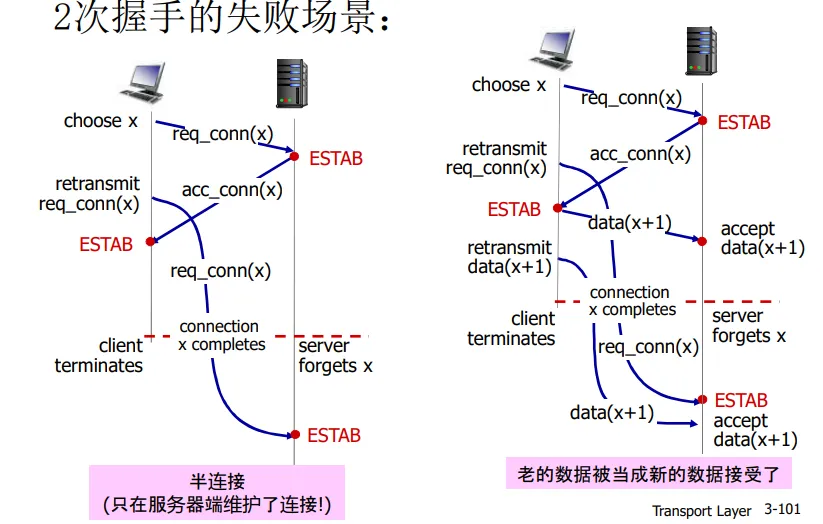
- 半连接即虚假连接,浪费服务器资源
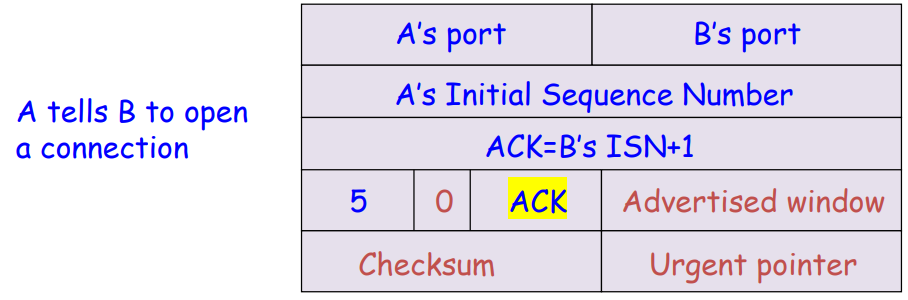
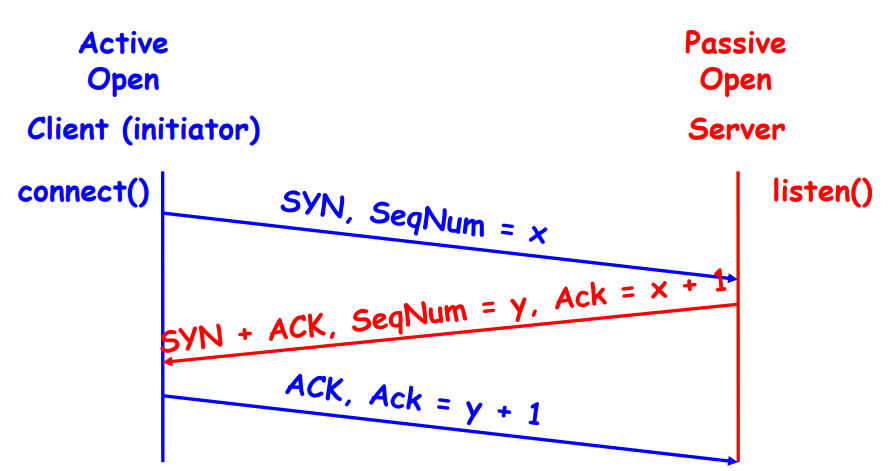
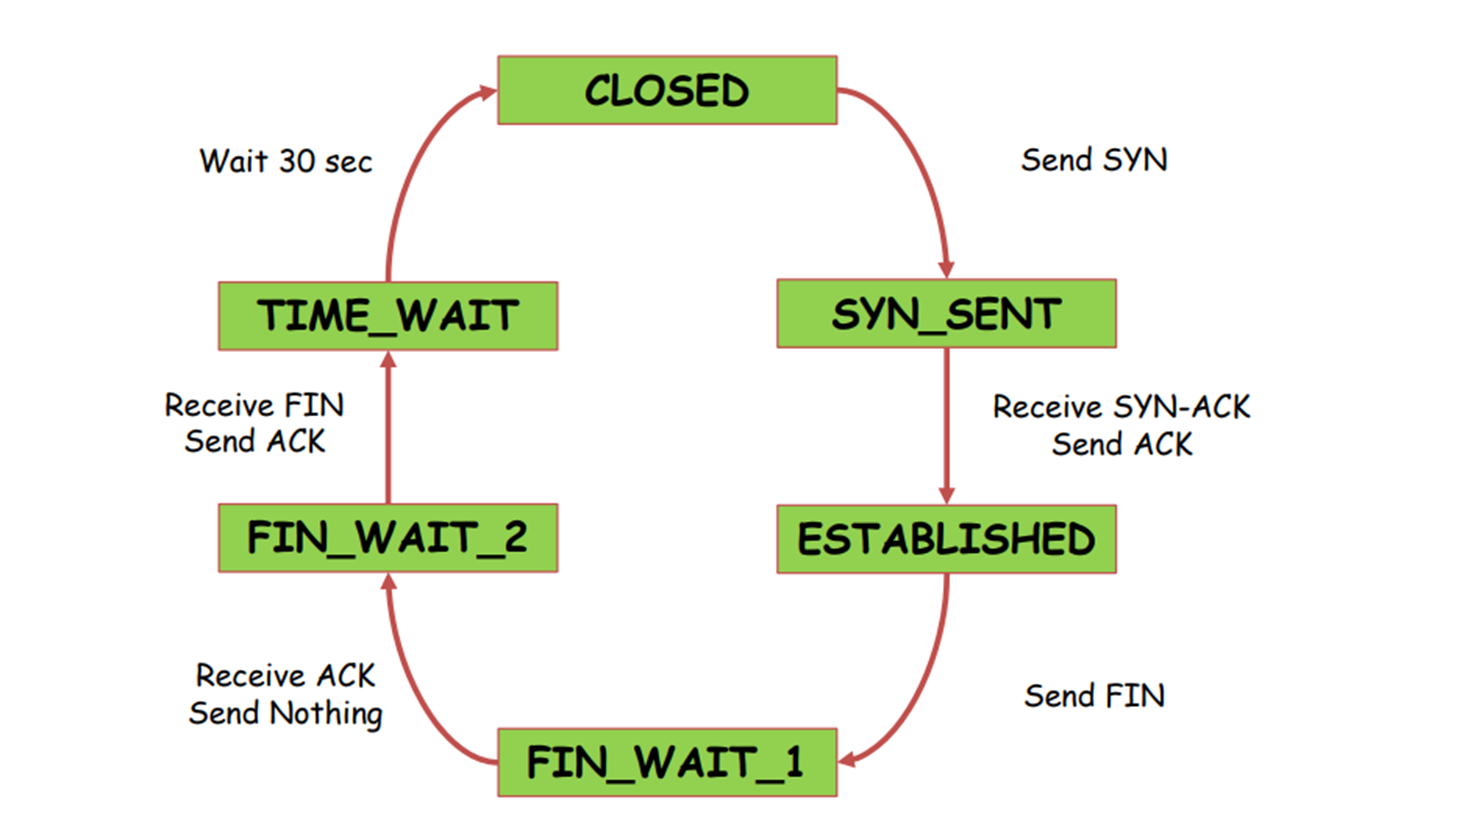
3 次握手
2 次握手缺陷的解决方案:变化的初始序号 + 双方确认对方的序号(3次握手)
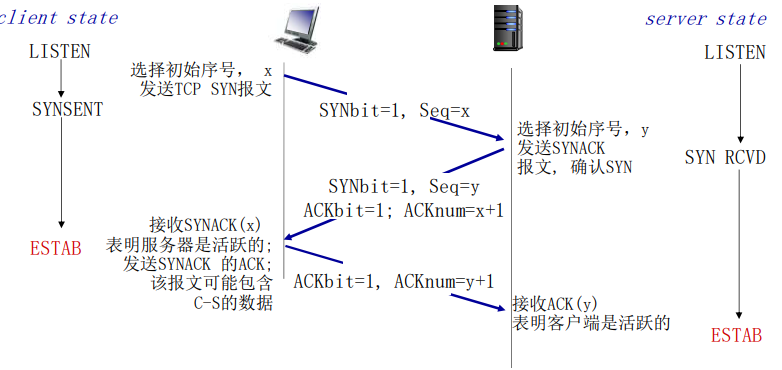
初始状态
- 客户端 (Client) 和 服务器 (Server) 一开始都处于
LISTEN(监听)状态,准备接收或发起连接。
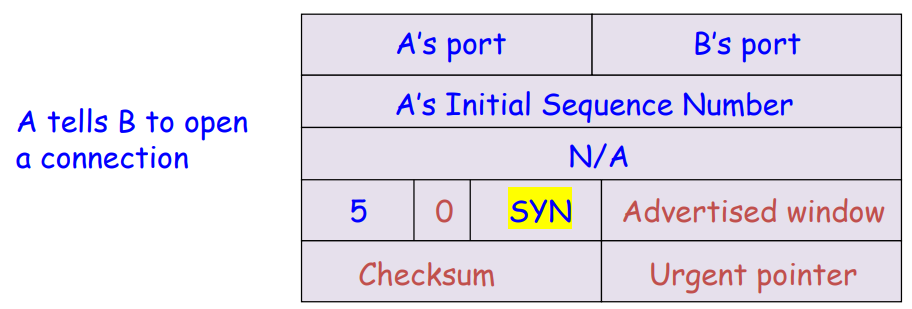
第一次握手:客户端发起连接请求
- 动作: 客户端选择一个随机的初始序号 \(x\)。
- 发送报文: 客户端向服务器发送一个 SYN 报文。报文头部中同步标志位
SYNbit = 1,序列号Seq = x。 - 状态变化: 客户端状态由
LISTEN变为SYNSENT(同步已发送),开始等待服务器的确认。 - 目的:告诉服务器,“我想建立连接,我的初始数据序号是 \(x\)”。
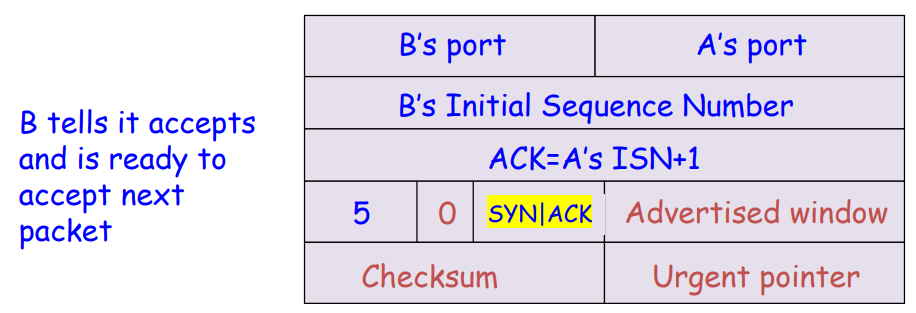
第二次握手:服务器接收请求并确认,同时发起自己的连接请求
- 动作: 服务器收到客户端的 SYN 报文后,同意建立连接。它也会为自己选择一个随机的初始序号 \(y\)。
- 发送报文: 服务器向客户端发送一个 SYNACK 报文。这个报文包含两部分功能:
- 确认 (ACK): 确认标志位
ACKbit = 1,确认号ACKnum = x + 1(表示序号 \(x\) 已经收到,期待收到 \(x+1\) 及之后的数据)。 - 同步 (SYN): 同步标志位
SYNbit = 1,序列号Seq = y。
- 确认 (ACK): 确认标志位
- 状态变化: 服务器状态变为
SYN RCVD(同步已接收)。 - 目的:告诉客户端,“我收到你的请求了(确认号 \(x+1\)),我也同意连接。我的初始数据序号是 \(y\)”。
第三次握手:客户端确认服务器的请求
- 动作: 客户端收到服务器的 SYNACK 报文后,知道服务器是活跃的并且同意了连接。
- 发送报文: 客户端再次发送确认报文。确认标志位
ACKbit = 1,确认号ACKnum = y + 1(表示收到了服务器的序号 \(y\))。- 第三次握手的报文是可以携带客户端到服务器的实际数据的。
- 状态变化: 客户端发送完确认后,立刻进入
ESTAB(Established,已建立连接)状态。服务器在收到这个确认报文后,也进入ESTAB状态。 - 目的:告诉服务器,“我收到了你的确认和你的初始序号(确认号 \(y+1\)),我们可以开始正式传输数据了”。
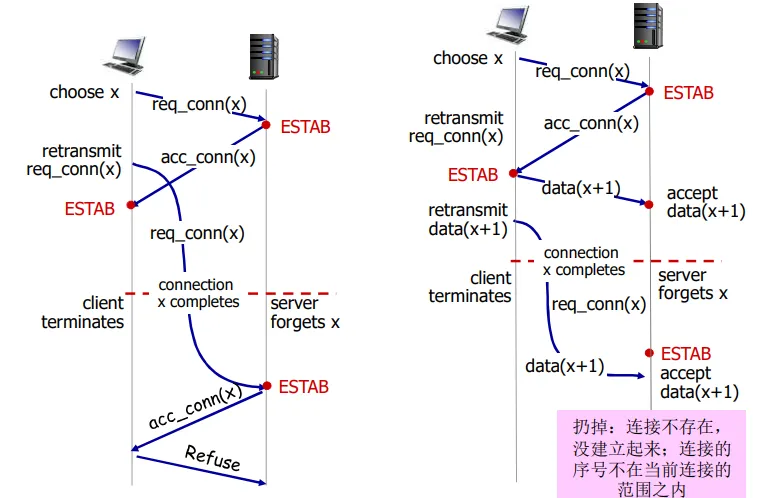
注意接收老数据问题中有两种情况:
- 连接不存在,没建立起来,丢弃
- 新连接建立了,旧数据来了
- 连接的序号不在当前连接的范围之内,丢弃
- 故初始序号的选取是随机的,不是固定序号开始
- 连接的序号不在当前连接的范围之内,丢弃
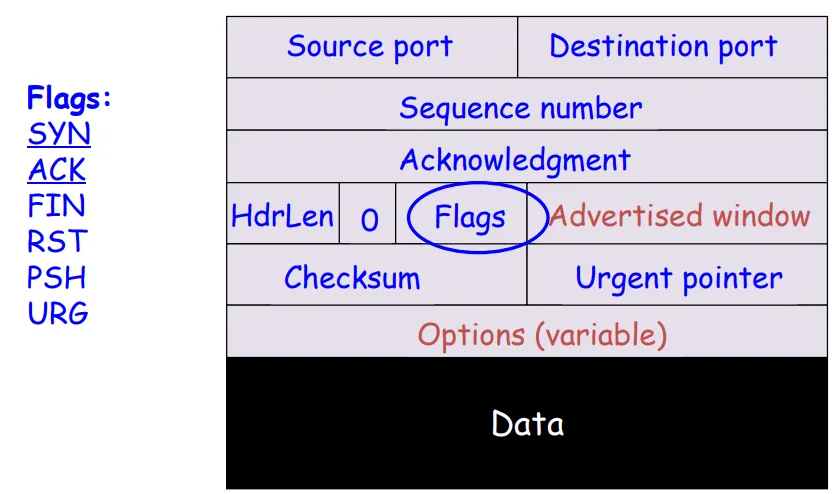
SYN 丢失与 Web 下载
- 用户点击超链接
- 浏览器创建套接字并执行“connect”
- “connect”触发操作系统发送 SYN
- 如果 SYN 丢失…
- 3–6 秒的延迟:可能非常漫长
- 用户可能会不耐烦并重试
- 用户触发“connect”的“中止”
- 浏览器创建新套接字并发起另一次“connect”
- 在某些情况下可能有效
关闭连接
- 客户端、服务器分别关闭它自己这一侧的连接
- 发送 FIN bit = 1 的 TCP 段
- 一旦接收到 FIN,用 ACK 回应
- 接到 FIN 段,ACK 可以和它自己发出的 FIN 段一起发送
- 可以处理同时的 FIN 交换
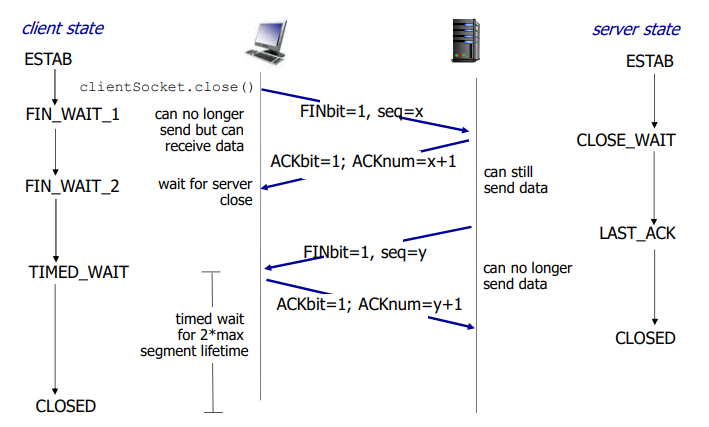
- 但关闭实则不完美,参考“山谷白军3000人,两边红军2000人,放通讯兵”
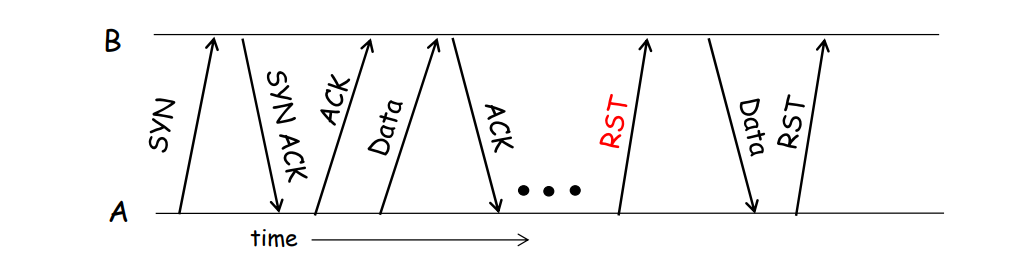
- A 向 B 发送 RESET(RST)
- 例如,因为 A 上的应用进程崩溃了
- 就这样
- B 不会对 RST 进行确认
- 因此,RST 不会被可靠传递,且所有正在传输中的数据都将丢失
- 但是:如果 B 再发送任何数据,将会触发另一个 RST
FIN 是礼貌的告别,而 RST 是粗暴的断交
TCP client lifecycle
TCP server lifecycle
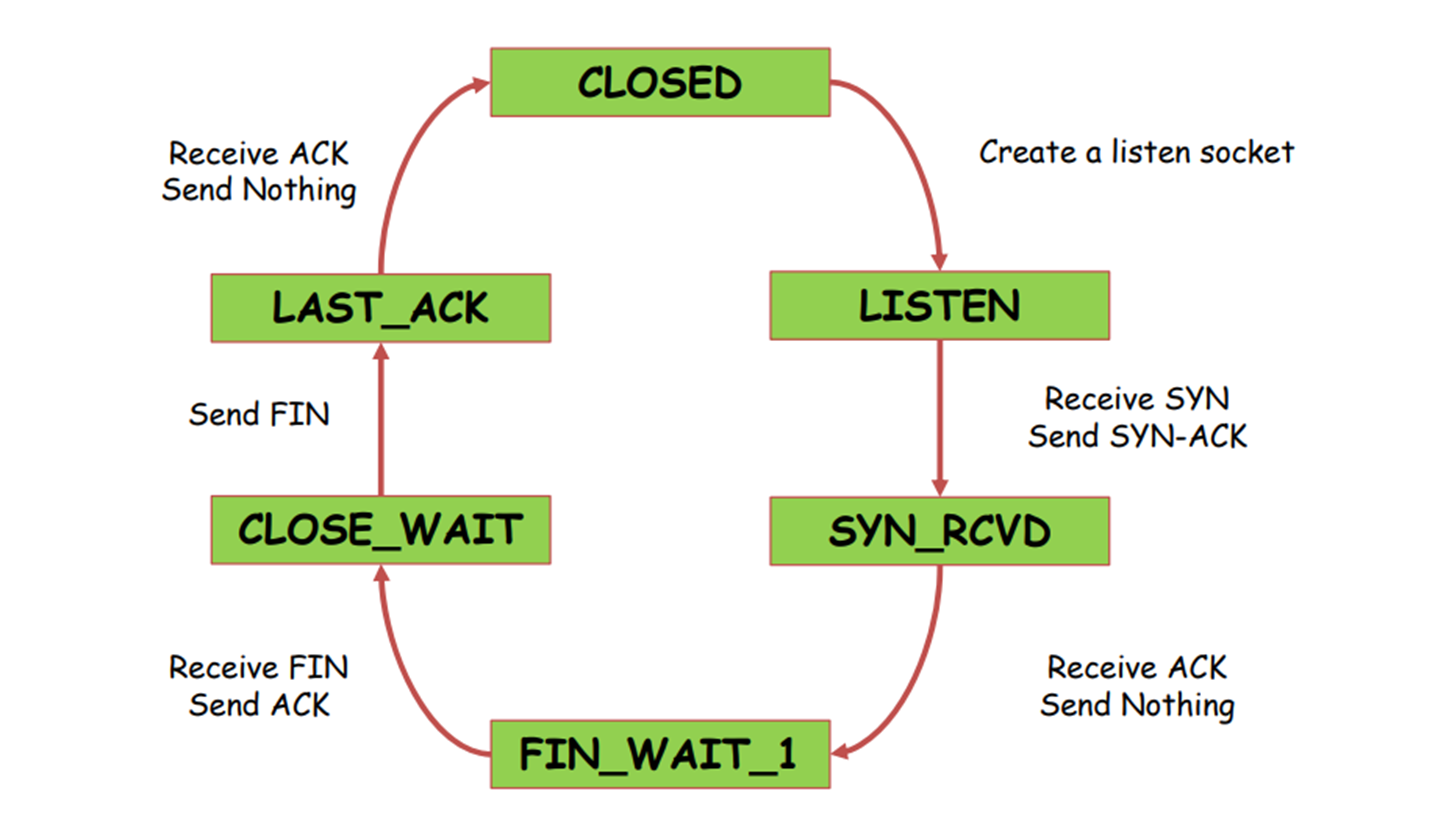
上图 TCP server lifecycle 有误,底部 FIN_WAIT_1 应改为 ESTABLISHED
5.4 流量控制
接收方控制发送方,不让发送方发送的太多、太快以至于让接收方的缓冲区溢出
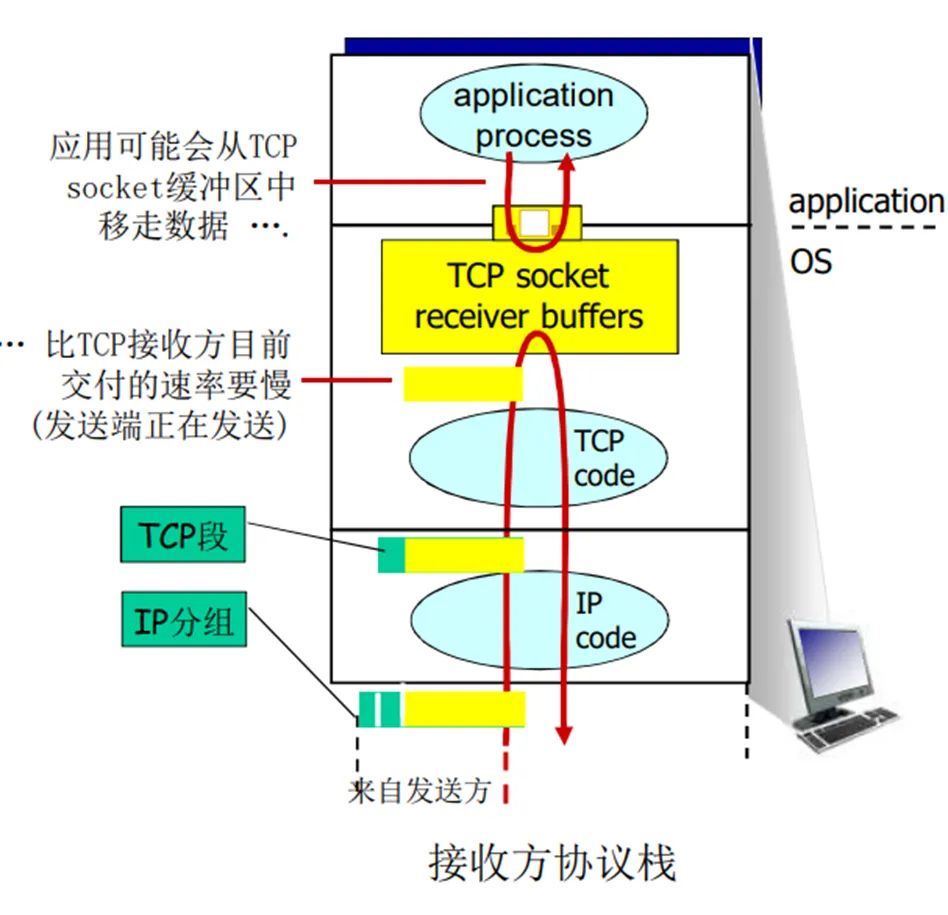
- 接收方在其向发送方的 TCP 段头部的 RWND 字段 “通告” 其空闲 buffer 大小
- RcvBuffer 大小通过 socket 选项设置 (典型默认大小为4096 字节)
- 很多操作系统自动调整 RcvBuffer
- 发送方限制未确认(在途)字节的个数 ≤ 接收方发送过来的 RWND 值
- 保证接收方不会被淹没
                    到应用进程
                        ⭡
LastByteRead -> +-----------------+ ---------------
                |                 |           ⭡
                |  buffered data  |           |
                |                 |       RcvBuffer
LastByteRcvd -> +-----------------+ ----      |
                |                 |  ⭡        |
                |free buffer space| RWND      |
                |                 |  ↓        ↓
                +-----------------+ ---------------
                        ⭡
                TCP segment payloads
假设 TCP 接收方丢弃乱序的报文段
缓存中的可用的空间 = RcvWindow = RcvBuffer-[LastByteRcvd - LastByteRead]
发送方滑动窗口
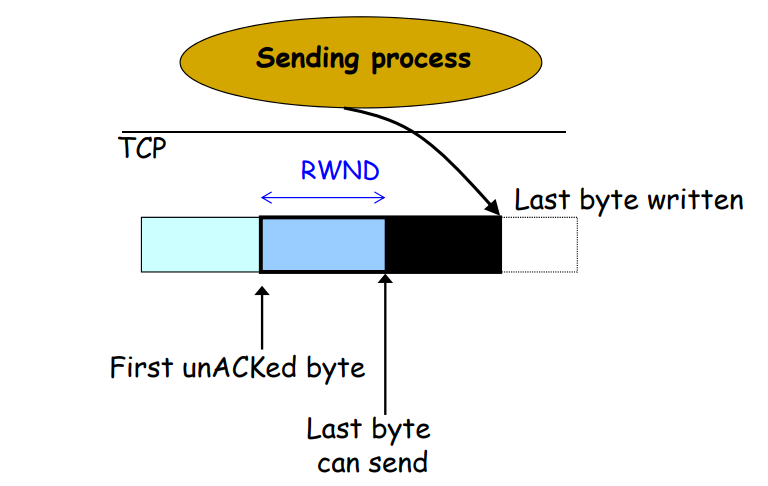
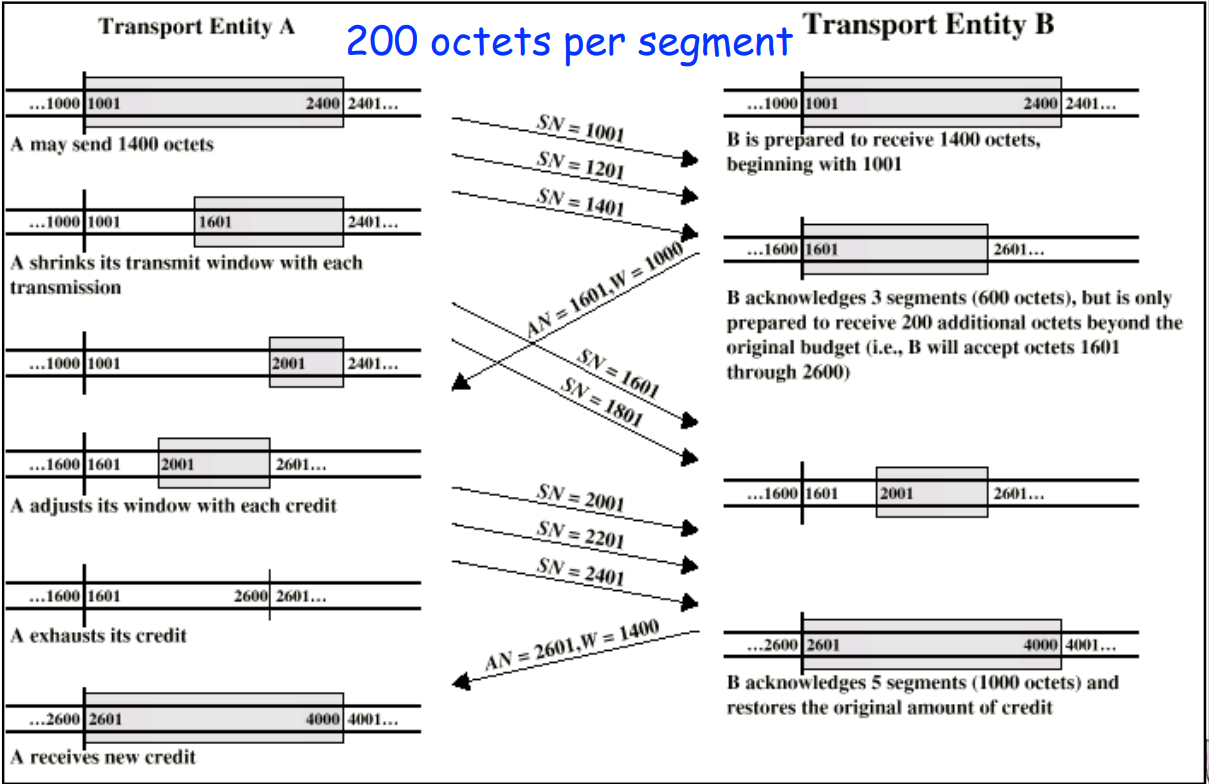
信用分配流量控制机制
-
假设 B 最后接收到的数据字节序号为 \(i-1\),B 最后发送的报文段为 \((AN=i, W=j)\)。则:
- 在没有新数据到达的情况下,要将信用额度增加到 \(k\)(\(k > j\)),B 发送 \((AN=i, W=k)\)
- 要确认一个包含 \(m\) 字节数据(\(m < j\))的到达报文段而不额外授予信用额度,B 发送 \((AN=i+m, W=j-m)\)
-
如果 ACK/CREDIT 报文段丢失,几乎没有损害。后续的确认将重新同步协议。
-
此外,如果发送方超时并重传数据报文段,它会触发新的确认。
信用分配死锁
-
B 向 A 发送:带有
AN=i,W=0的报文段,关闭接收窗口 -
B 向 A 发送:
AN=i,W=j以重新打开,但这个报文可能丢失 -
现在 A 认为窗口已关闭,B 认为窗口已打开并等待
-
处理方法
- 使用
窗口定时器 - 如果定时器超时而没有收到任何数据,(A)发送一些东西
- 可以是之前报文段的重传
- 使用
6. 拥塞控制原理
- 拥塞的非正式的定义: “太多的数据需要网络传输,超过了网络的处理能力”
- 与流量控制不同
- 拥塞的表现:
- 分组丢失 (路由器缓冲区溢出)
- 分组经历比较长的延迟 (在路由器的队列中排队)
6.1 拥塞的原因/代价
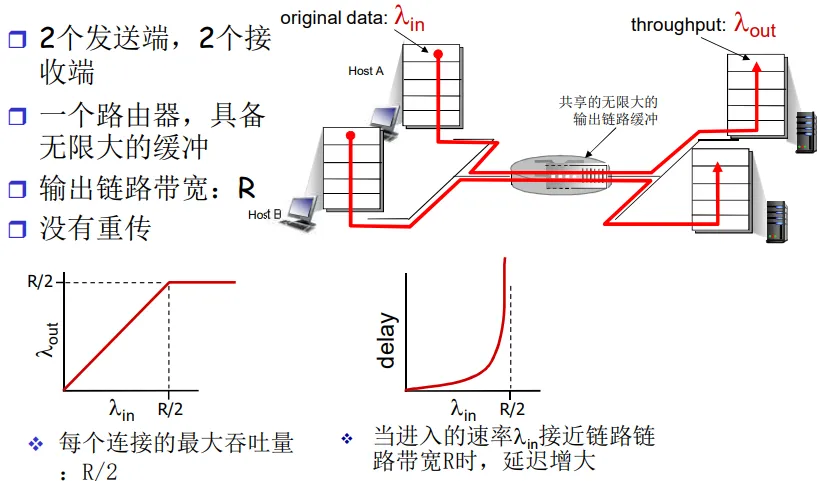
场景 1
场景 2
- 一个路由器,有限的缓冲
- 分组丢失时,发送端重传
- 应用层的输入 = 应用层输出: \(\lambda_{in} = \lambda_{out}\)
- 传输层的输入包括重传: \(\lambda^{'}_{in} > \lambda_{in}\)
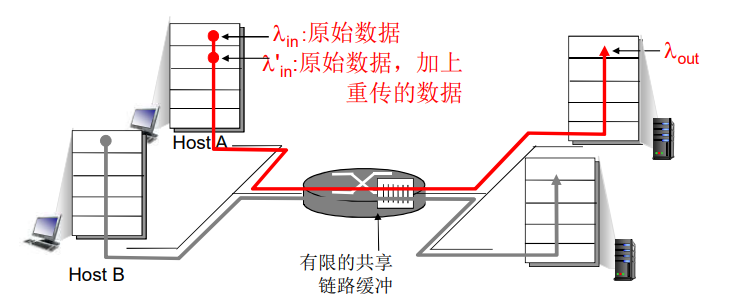
理想化: 发送端有完美的信息
- 发送端知道什么时候路由器的缓冲是可用的
- 只在缓冲可用时发送
- 不会丢失: \(\lambda^{'}_{in} = \lambda_{in}\)
现实情况: 重复
- 分组可能丢失,由于缓冲器满而被丢弃
- 发送端最终超时,发送第2个拷贝,2个分组都被传出
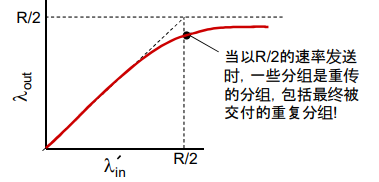
拥塞的“代价”:
- 为了达到一个有效输出,网络需要做更多的工作(重传)
- 没有必要的重传,链路中包括了多个分组的拷贝
- 是那些没有丢失,经历的时间比较长(拥塞状态)但是超时的分组
- 输出比输入少原因
- 重传的丢失分组
- 没有必要重传的重复分组
场景 3
4个发送端、多重路径、超时/重传
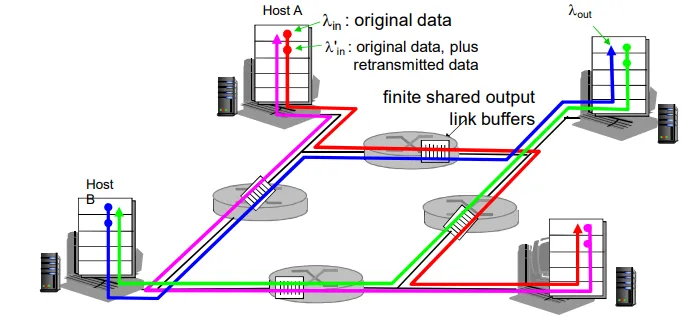
当红色的 \(\lambda^{'}_{in}\) 增加时,所有到来的蓝色分组都在最上方的队列中丢弃了,蓝色吞吐 -> 0
蓝色受阻,又不断重传,导致蓝色第一跳的路由器缓冲区溢出,形成“死锁”
又一个拥塞的代价:
- 当分组丢失时,任何“关于这个分组的上游传输能力”都被浪费了
- 第二跳出不去,第一跳白费了
6.2 拥塞控制方法
2 种常用的拥塞控制方法:
端到端拥塞控制:
- 没有来自网络的显式反馈
- 端系统根据延迟和丢失事件推断是否有拥塞
- TCP 采用的方法
网络辅助的拥塞控制:
- 路由器提供给端系统以反馈信息
- 单个bit置位,显示有拥塞
- 显式提供发送端可以采用的速率
7 TCP 拥塞控制
端到端的拥塞控制机制:
- 路由器不向主机提供有关拥塞的反馈信息
- 路由器的负担较轻
- 符合网络核心简单的TCP/IP架构原则
- 端系统根据自身得到的信息,判断是否发生拥塞,从而采取动作
拥塞控制的几个问题:
- 如何检测拥塞
- 轻微拥塞
- 拥塞
- 控制策略
- 在拥塞发生时如何动作,降低速率
- 在拥塞缓解时如何动作,增加速率
速率调节
- 基本结构
- 收到 ACK(新数据的确认)时:增大速率
- 检测到丢包时:减小速率
- 增大/减小速率的方式取决于所处的拥塞控制阶段:
- 探测可用的瓶颈带宽(慢启动)
- 适应带宽波动(拥塞避免:AIMD)
7.1 拥塞感知
发送端如何探测到拥塞?
- 某个段超时了(丢失事件):拥塞
- 原因1:网络拥塞(某个路由器缓冲区没空间了,被丢弃)概率大
- 原因2:出错被丢弃了(各级错误,没有通过校验,被丢弃)概率小
- 一旦超时,就认为拥塞了,有一定误判,但是总体控制方向是对的
- 有关某个段的 3 次重复 ACK:轻微拥塞
- 段的第 1 个 ack,正常,确认绿段,期待红段
- 段的第 2 个重复 ack,意味着红段的后一段收到了,蓝段乱序到达
- 段的第 2、3、4 个 ack 重复,意味着红段的后第 2、3、4 个段收到了,橙段乱序到达,同时红段丢失的可能性很大(后面 3 个段都到了,红段都没到)
- 网络这时还能够进行一定程度的传输,拥塞但情况要比第一种好
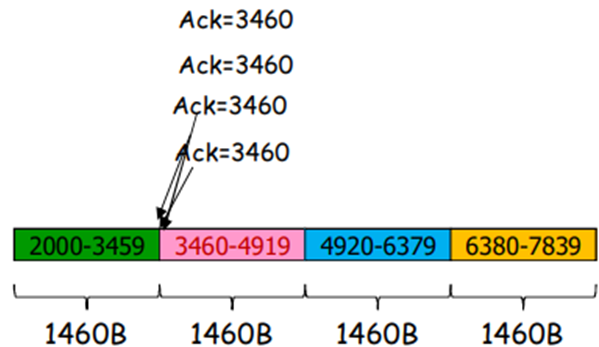
- 上图中的 4 个确认,1 个正常确认,3 个重复确认
7.2 速率控制方法
如何控制发送端发送的速率?
- 维持一个拥塞窗口的值:CongWin
- 发送端限制已发送但是未确认的数据量(的上限):
- 从而粗略地控制发送方的往网络中注入的速率
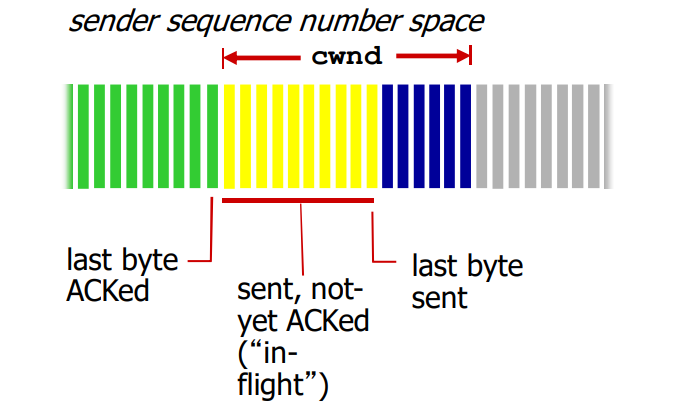
CongWin 是动态的,是感知到的网络拥塞程度的函数
- 超时或者 3 个重复 ack,CongWin ↓
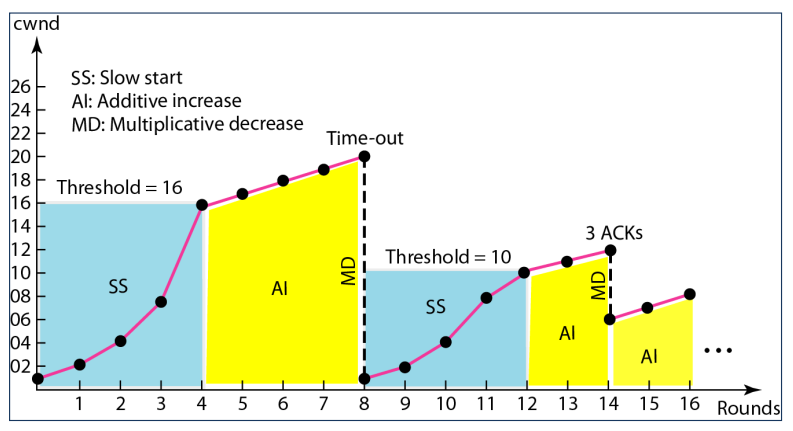
- 超时时:CongWin 降为 1MSS,进入 SS 阶段然后再倍增到 CongWin/2(每个RTT),从而进入 CA 阶段
- 3个重复ack :CongWin 降为 CongWin/2,CA 阶段
- 否则(正常收到Ack,没有发生以上情况):CongWin跃跃欲试 ↑
- SS 阶段:加倍增加(每个RTT)
- CA 阶段:线性增加(每个RTT)
拥塞控制和流量控制的联合动作:
- 发送端控制发送但是未确认的量同时也不能够超过接收窗口,满足流量控制要求
- 同时满足拥塞控制和流量控制要求
7.3 拥塞控制策略
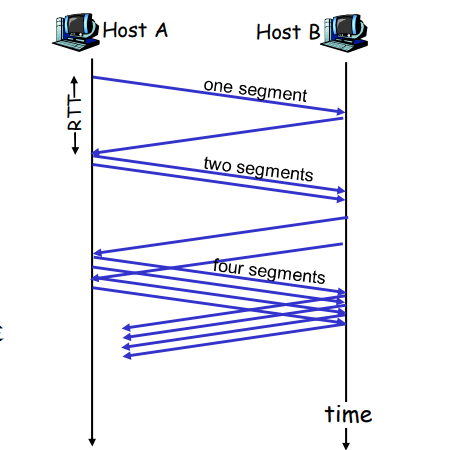
慢启动
- 连接刚建立,CongWin = 1MSS
- 可用带宽可能 >> MSS/RTT
- 应该尽快加速,到达希望的速率
- 当连接开始时,指数性增加(每个RTT)发送速率,直到发生丢失的事件
- 每一个 RTT, CongWin 加倍
- 每收到一个 ACK 时,CongWin 加1(即完成加倍)
- 慢启动阶段:只要不超时或 3 个重复 ack,一个 RTT, CongWin 加倍
- 总结: 初始速率很慢,但是加速却是指数性的
- 指数增加,SS 时间很短,长期来看可以忽略
AIMD/超时之后的保守策略
AIMD (Additive Increase Multiplicative Decrease): 加性增,乘性减
- 阈值变量:ssthresh
- 出现丢失,ssthresh 设置成 CongWin 的 1/2
- If CWND(CongWin) > ssthresh, stop Slow Start
加性增:
- 当 CongWin > 阈值 时,一个 RTT 如没有发生丢失事件,将 CongWin 加 1MSS:探测
乘性减:
- 当收到 3 个重复的 ACKs:
- ssthresh = CWND/2
- CWND = ssthresh
- 进入拥塞避免:每个 RTT 后 cwnd 增加 1(线性而非指数增长)
- 当超时事件发生时:
- ssthresh = CWND/2
- CWND = 1
- 启动慢启动
在超时之前,当 CongWin 变成上次发生超时的窗口的一半
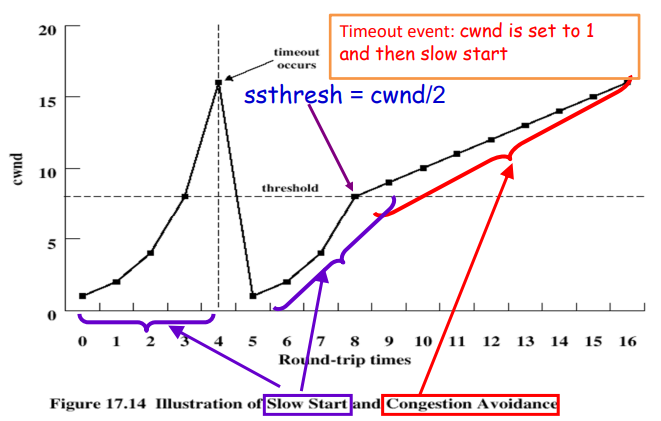
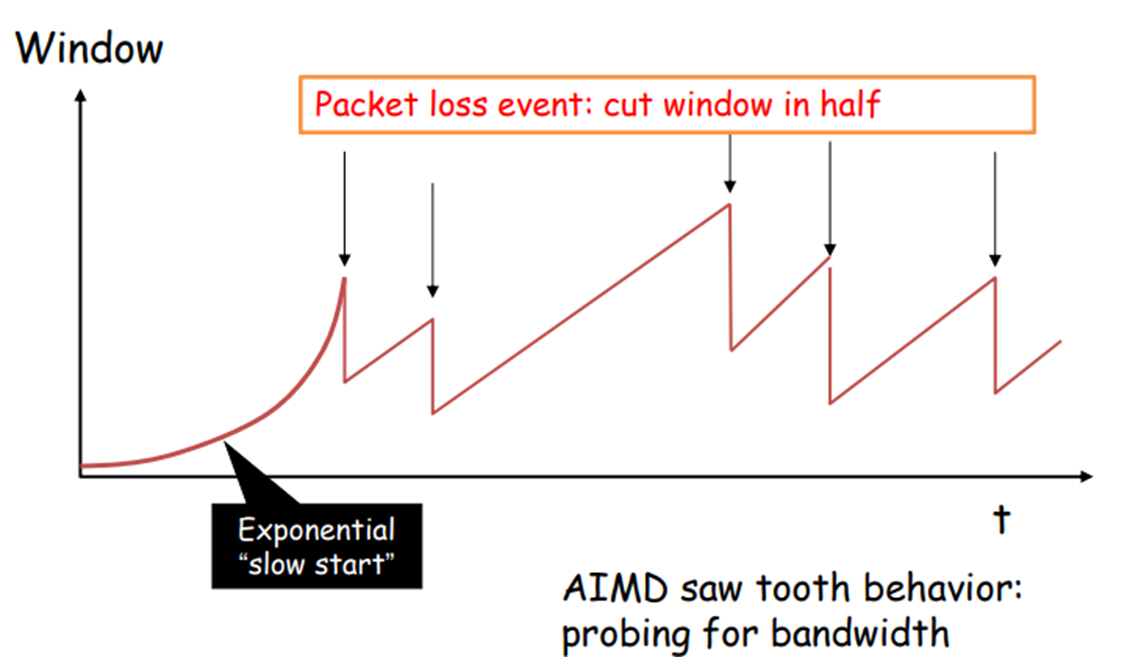
总结: TCP发送端拥塞控制
- 当
CongWin < Threshold,发送端处于慢启动阶段(slow-start),窗口指数性增长 - 当
CongWin > Threshold,发送端处于拥塞避免阶段(congestion-avoidance),窗口线性增长 - 当收到三个重复的ACKs(
triple duplicate ACK),Threshold设置成CongWin/2,CongWin = Threshold + 3(+3?3个重复ack) - 当超时事件发生时
timeout,Threshold = CongWin / 2,CongWin = 1 MSS,进入SS阶段
| 事件 | 状态 | TCP 发送端行为 | 解释 |
|---|---|---|---|
| 以前没有收到ACK的data被ACKed | 慢启动 (SS) | CongWin = CongWin + MSSIf ( CongWin > Threshold)状态变成 “CA” |
每一个RTT CongWin 加倍 |
| 以前没有收到ACK的data被ACKed | 拥塞避免 (CA) | CongWin = CongWin + MSS * (MSS / CongWin) |
加性增加,每一个RTT对 CongWin 加一个 1 MSS |
| 通过收到3个重复的ACK,发现丢失的事件 | SS or CA | Threshold = CongWin / 2CongWin = Threshold + 3状态变成 “CA” |
快速重传,实现乘性的减。CongWin 没有变成 1 MSS. |
| 超时 | SS or CA | Threshold = CongWin / 2CongWin = 1 MSS状态变成 “SS” |
进入slow start |
| 重复的 ACK | SS or CA | 对被ACKed的segment,增加重复ACK的计数 | CongWin and Threshold 不变 |
7.4 TCP 吞吐量
- TCP 的平均吞吐量是多少,使用窗口尺寸 W 和 RTT 来描述?
- 忽略慢启动阶段,假设发送端总有数据传输
- W:发生丢失事件时的窗口尺寸(单位:字节)
- 平均窗口尺寸(in flight 字节):3/4 W
- 平均吞吐量:RTT 时间吞吐 3/4 W
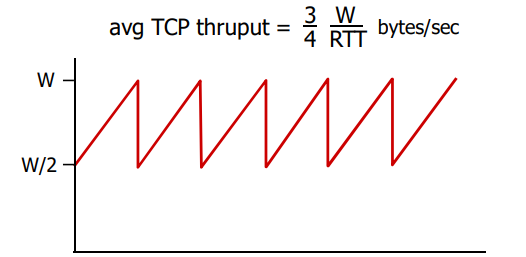
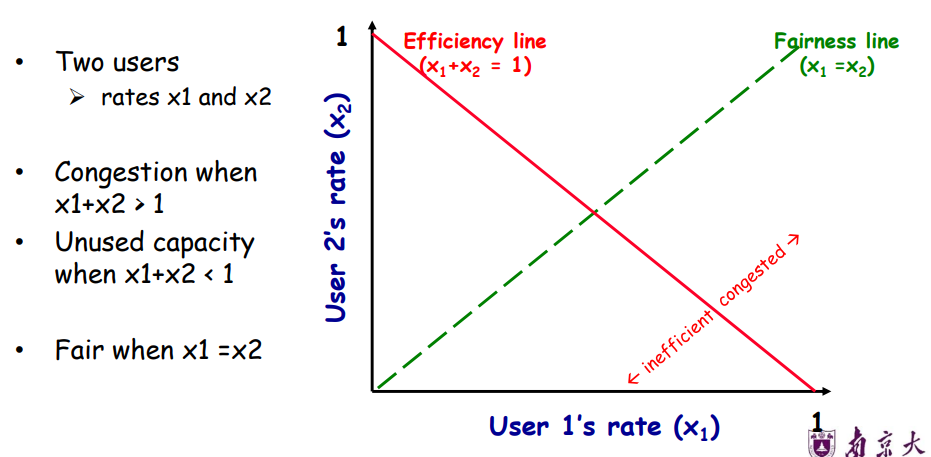
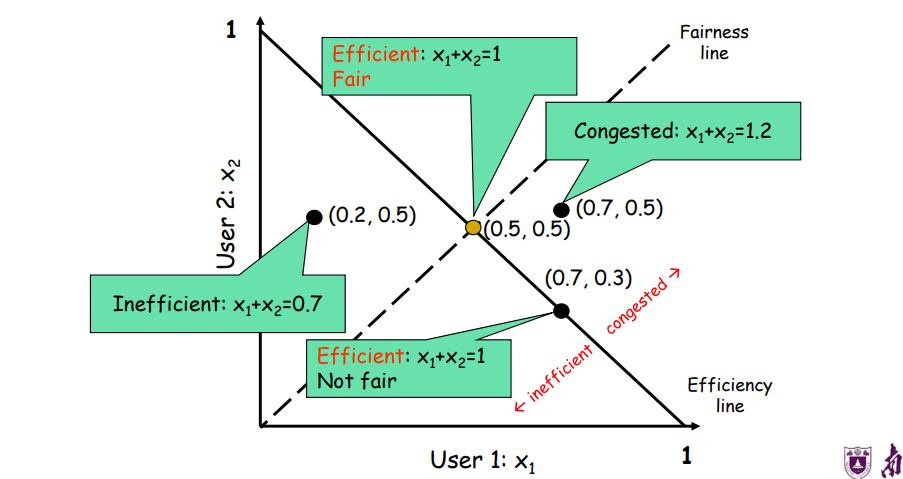
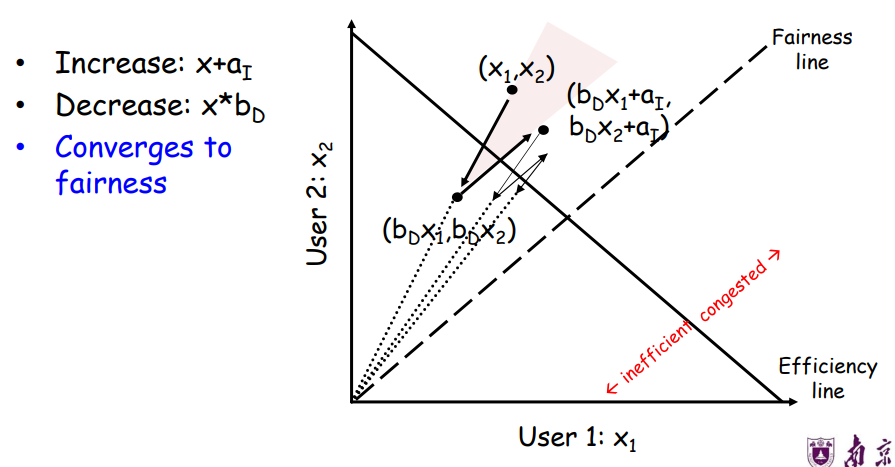
7.5 TCP 公平性
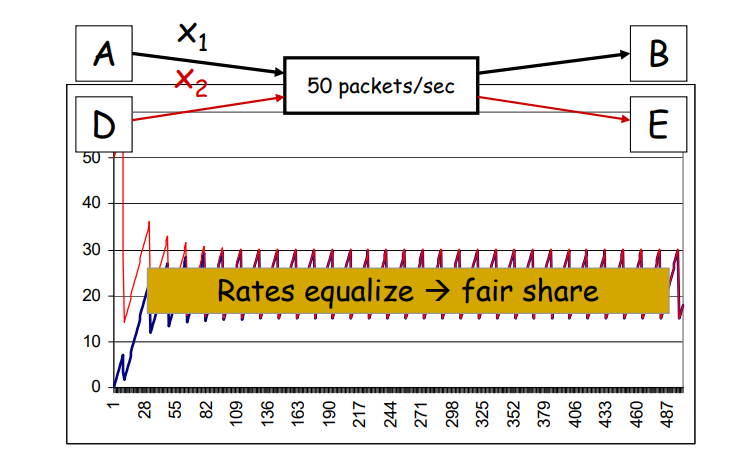
公平性目标: 如果 K 个 TCP 会话分享一个链路带宽为 R 的瓶颈,每一个会话的有效带宽为 R/K
为什么TCP是公平的?2个竞争的TCP会话:
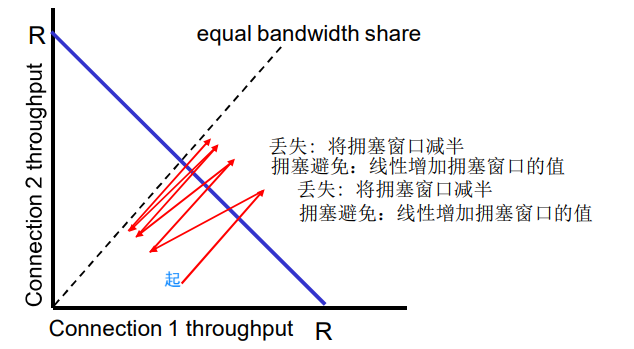
- 会收敛至 x = y
公平性和 UDP:
- 多媒体应用通常不是用 TCP
- 应用发送的数据速率希望不受拥塞控制的节制
- 使用UDP:
- 音视频应用泵出数据的速率是恒定的,忽略数据的丢失
- 研究领域: TCP 友好性
公平性和并行TCP连接:
- 2个主机间可以打开多个并行的TCP连接
- Web浏览器
- 例如: 带宽为R的链路支持了9个连接
- 如果新的应用要求建1个TCP连接,获得带宽R/10
- 如果新的应用要求建11个TCP连接,获得带宽R/2
7.6 TCP 快速恢复
TCP协议拥塞控制 的一个核心机制:快速恢复 (Fast Recovery)。它通常与“快速重传”配合使用。
简单来说,当网络出现轻微拥塞(表现为丢包)时,快速恢复机制允许发送方不要像遇到“超时”那样直接把发送窗口降到1,而是利用一种“临时信用”机制继续发送数据,保持网络的吞吐量。
1. 核心思想 (Idea)
Grant the sender temporary “credit” for each dupACK so as to keep packets in flight (为每一个重复确认ACK赋予发送方临时的“信用额度”,以保持网络中有数据包在飞行)
- 背景理解:当发送方收到重复的ACK(dupACK)时,意味着某个特定的数据包丢失了,但是后续的数据包已经成功到达接收端(接收端收到乱序包就会触发dupACK)。这说明网络并没有完全瘫痪,只是偶尔丢包。
- 做法:既然知道有包离开了网络(到达了接收端),发送方就可以利用这些 dupACK 作为“信用”,继续向网络中发送新的数据包,而不是停下来干等。
2. 触发条件与初始动作 (If dupACKcount = 3)
当发送方连续收到 3个重复的ACK 时,触发快速重传和快速恢复机制:
-
ssthresh = CWND / 2- 解释:将“慢启动阈值 (ssthresh)”设置为当前“拥塞窗口 (CWND)”的一半。这是因为发生了丢包,说明网络开始拥塞,必须做出退让,将门限值减半。
-
CWND = ssthresh + 3- 解释:将拥塞窗口设置为新的阈值加上 3。
- 为什么是 +3? 因为你收到了3个重复的ACK,这意味着有3个数据包已经成功离开了网络并被接收端缓存。既然网络里腾出了3个包的空间,发送方就可以把窗口人为“放大”3个单位,以便后续能发送新的包.
3. 处于快速恢复阶段 (While in fast recovery)
CWND = CWND + 1 for each additional dupACK
- 解释:在快速恢复状态下,每多收到一个额外的重复ACK,就把拥塞窗口
CWND增加 1。 - 原理:每一个额外的 dupACK 都代表又有一个数据包安全离开了网络到达了接收端缓冲区。窗口加1,发送方就可以借此“额度”再向网络中发送一个新包。这样不仅重传了丢失的包,还保证了网络管道里始终有数据在流动(keep packets in flight)。
4. 退出快速恢复 (Exit fast recovery)
Exit fast recovery after receiving new ACK set CWND = ssthresh
- 解释:当发送方收到了一个 新的ACK(这个ACK确认了之前丢失的包已经被成功接收到了),这就标志着丢失的包已经被补上,快速恢复阶段结束。
- 动作:此时,将
CWND回调至之前记录的ssthresh的值。 - 原理:因为之前那个被放大的
CWND(加了3,又加了若干个1)只是为了在丢包期间人为制造发送额度。现在丢包危机解除,需要把这个“虚高”的窗口收回,恢复到正常的安全门限值(一半的水平),随后TCP会进入拥塞避免 (Congestion Avoidance) 阶段,窗口开始缓慢线性增长。
Example
- Consider a TCP connection with:
- CWND=10 packets
- Last ACK was for packet # 101
- i.e., receiver expecting next packet to have seq. no. 101
- 10 packets [101, 102, 103,…, 110] are in flight
- Packet 101 is dropped
- ACK 101 (due to 102) cwnd=10 dup#1
- ACK 101 (due to 103) cwnd=10 dup#2
- ACK 101 (due to 104) cwnd=10 dup#3
- RETRANSMIT 101 ssthresh=5 cwnd=8 (5+3)
- ACK 101 (due to 105) cwnd=9 (no xmit)
- ACK 101 (due to 106) cwnd=10 (no xmit)
- ACK 101 (due to 107) cwnd=11 (xmit 111)
- ACK 101 (due to 108) cwnd=12 (xmit 112)
- ACK 101 (due to 109) cwnd=13 (xmit 113)
- ACK 101 (due to 110) cwnd=14 (xmit 114)
- ACK 111 (due to 101) cwnd = 5 (xmit 115) ← exiting fast recovery
- Packets 111-114 already in flight
- ACK 112 (due to 111) cwnd = 5 + 1/5 ← back in cong. avoidance
1. 触发阶段:收到 3 个重复 ACK
接收端每收到一个乱序的包(102, 103, 104),就会回复一个期望收到 101 的 ACK。
ACK 101 (due to 102) cwnd=10 dup#1:收到包 102,回复第 1 个重复 ACK 101。ACK 101 (due to 103) cwnd=10 dup#2:收到包 103,回复第 2 个重复 ACK 101。ACK 101 (due to 104) cwnd=10 dup#3:收到包 104,回复第 3 个重复 ACK 101。
2. 进入快速恢复:重传与调整窗口
RETRANSMIT 101 ssthresh=5 cwnd= 8 (5+3)- 动作:集齐 3 个 dupACK,触发快速重传,立即重发丢失的包 101。
- 状态更新:根据课件公式,门限值减半:\(ssthresh = 10 / 2 = 5\)。拥塞窗口设置为:\(cwnd = ssthresh + 3 = 8\)。
- 进入快速恢复状态。
3. 快速恢复进行中:窗口“膨胀”与发送新包
此时网络中还有其他原本发送的包(105-110)在陆续到达接收端,每到达一个,接收端就会发回一个 dupACK 101。
ACK 101 (due to 105) cwnd= 9 (no xmit):收到额外的 dupACK,\(cwnd\) 加 1 变成 9。但此时网络中未确认的包数量(101-110,共10个包)仍然大于 \(cwnd\),所以不发送新包(no xmit)。ACK 101 (due to 106) cwnd=10 (no xmit):\(cwnd\) 变成 10。未确认的包数量等于 \(cwnd\),依然不发送。
(关键转折点:开始利用“信用额度”发送新包)
ACK 101 (due to 107) cwnd=11 (xmit 111):收到包 107 的 dupACK,\(cwnd\) 膨胀到 11。此时 \(cwnd\) (11) 终于大于了原来在飞行中的包数量 (10)。发送方利用这个多出来的 1 个“额度”,发送了全新的数据包 111。ACK 101 (due to 108) cwnd=12 (xmit 112):继续收到 dupACK,窗口继续膨胀,发送新包 112。ACK 101 (due to 109) cwnd=13 (xmit 113):发送新包 113。ACK 101 (due to 110) cwnd=14 (xmit 114):发送新包 114。
这就是课件中“Keep packets in flight”的完美体现:虽然我们在等包 101 被确认,但通过人为放大窗口,我们并没有闲着,而是继续把 111-114 这几个新包送进了网络管道。
4. 退出快速恢复
ACK 111 (due to 101) cwnd = 5 (xmit 115)- 发生了什么:之前重传的包 101 终于到达了接收端!接收端此时已经完美拼齐了 101 到 110 的所有数据。于是它发送了一个新的(累积的)ACK 111(意思是:110及之前的我都收到了,我接下来要 111)。
- 动作:收到新的 ACK,退出快速恢复 (exiting fast recovery)。
- 状态更新:根据课件公式,将窗口缩小回安全阈值,即 \(cwnd = ssthresh = 5\)。同时根据此时的窗口情况,发送新包 115。
5. 回到拥塞避免 (Congestion Avoidance)
ACK 112 (due to 111) cwnd = 5 + 1/5- 发生了什么:刚才在快速恢复期间“偷空”发出去的新包 111 到达了接收端,接收端回复 ACK 112。
- 状态更新:此时 TCP 已经退出了快速恢复,处于拥塞避免阶段。在这个阶段,每收到一个 ACK,窗口不再呈指数增长,而是线性增长:\(cwnd = cwnd + 1/cwnd\)。所以 \(cwnd\) 变成了 \(5 + 1/5\)。(每个 RTT 才是 + 1)
7.7 TCP state machine
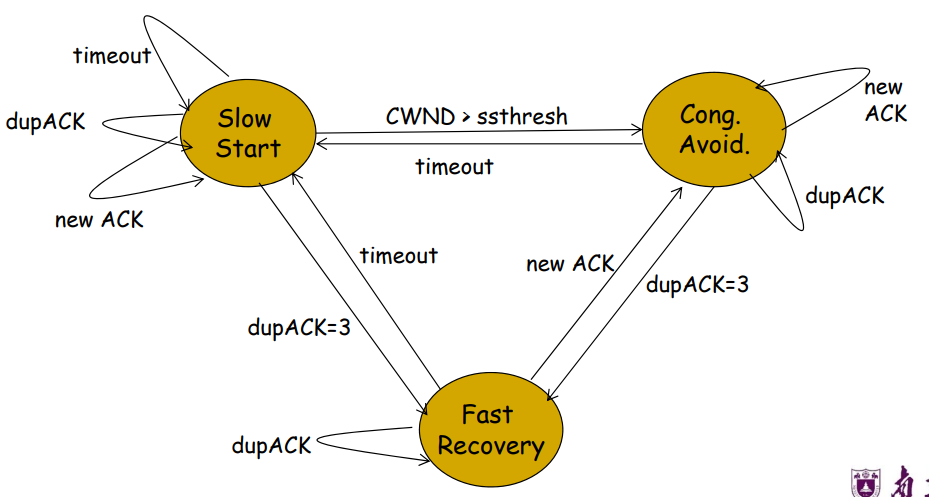
- Timeouts ➔ Slow Start
- dupACKs ➔ Fast Recovery
- New ACK changes state ONLY from Fast Recovery
7.8 TCP flavors
- TCP-Tahoe
➤ 收到 3 个重复 ACK 时 CWND = 1 - TCP-Reno
➤ 超时时 CWND = 1
➤ 收到 3 个重复 ACK 时 CWND = CWND/2 - TCP-newReno(我们的默认假设) ➤ TCP-Reno + 改进的快速恢复
- TCP-SACK
➤ 引入了选择性确认
它们如何共存?
- 所有变体都遵循同样的原则
- 好消息时增大 CWND
- 坏消息时减小 CWND
7.9 Router assisted congestion control
ECN 通过在数据包头部设置单个警告位,让路由器在拥塞初期主动通知端主机,使其在不丢包的情况下执行与丢包相同的拥塞控制反应,从而在链路利用率与传输延迟之间取得更优平衡。
1. 信号传递流程
- 路由器标记:当路由器检测到队列即将拥塞时,不是直接丢包,而是将经过的数据包头部中的 ECN 警告位(Warning Bit) 置为 1。
- 接收方反馈:接收方收到带 ECN 标记的数据包后,会在返回的 ACK 报文中设置 ECN-Echo 位,将拥塞信号传回发送方。
- 发送方响应:发送方收到带 ECN-Echo 的 ACK 后,立即执行拥塞控制(如减半 CWND),其反应逻辑与收到丢包信号(3 DupACKs 或 Timeout)完全一致。
2. 核心优势:无损拥塞通知
- 避免丢包:传统 TCP 必须等到丢包才知拥塞,而 ECN 在丢包前就发出预警,消除了不必要的重传和窗口剧烈回退。
- 降低延迟:由于减少了丢包重传,端到端延迟和抖动显著降低,尤其对实时应用(视频、语音)友好。
- 提升利用率:路由器无需通过丢包来“惩罚”发送方,可以更充分地利用链路缓冲,避免因丢包导致的吞吐量骤降。
3. 关键权衡:利用率 vs 延迟
- 标记阈值:路由器在队列多满时设置 ECN 位,是一个关键配置点。
- 阈值过低:过早标记,发送方频繁降速 → 延迟低,但链路利用率不足。
- 阈值过高:过晚标记,队列积压严重 → 利用率高,但延迟和抖动增大,甚至可能退化为丢包。
- 语义等价性:ECN 的拥塞语义被设计为与丢包完全等价,确保与现有 TCP 变体(Reno, SACK 等)的兼容性和公平性,无需修改核心拥塞控制算法。
💡 本质洞察:ECN 将 TCP 的拥塞反馈从 “事后惩罚”(丢包) 升级为 “事前预警”(标记),在不改变端主机行为逻辑的前提下,用更低的代价(一个比特)换取了更平滑的流量控制和更优的网络性能。
标题:3 传输层
作者:Zwing
创建于:2026-08-08 06:49:13
更新于:2026-08-07 23:07:52
链接:https://zanytriumph.github.io/posts/3 传输层.html
版权声明:本文章采用 CC BY-NC-SA 4.0 进行许可